
作品集
我在 GitHub 上共有 31 个公开项目,方向集中在大模型 Agent 工程、Skill 体系与数据智能。 本页收录 14 个代表性项目,按两条能力主线编排: 主线是 Agent 与大模型工程,支撑线是工程规范与数据能力。 每项都比 README 更细地展开:架构决策、核心实现、使用流程与运行证据。
关于「验证状态」的说明
为了避免夸大,本页每个项目都标注了验证口径,含义如下:
- ✅ 已实机运行验证 —— 由我(构建本站时)在真实环境启动并调用过接口,证据可复现
- 📷 项目自带真实截图 —— 项目内附截图,由仓库自带的自动化脚本从真实运行 UI 捕获
- 🔍 代码审计通过 —— 代码与文档完整、调用链自洽,但我未在构建环境下实际运行
- 🔧 二次开发 —— 基于他人的开源项目改造而来,页面内明确标注了上游来源与我的具体改动
我没有为任何项目伪造运行截图。凡无法真实验证的,一律如实标注。
项目一览
主线 · Agent 与大模型工程
我的主要方向:从 Agent 运行时、协作、编排,到 Skill 的编译与蒸馏,再到 LLM 工具链与端侧应用。
支撑 · 工程规范与数据能力
证明我能按企业级标准持续迭代项目(大数据技术专业 + 工程规范实践)。
AgentOS
github.com/laolaola278-dev/agentos
解决什么问题
让 Agent 改代码,最难的不是"让它动起来",而是怎么相信它真的改对了。 很多 Agent 框架由模型自己宣布"任务完成",缺乏客观证据。AgentOS 的核心设计是: 任务只有在「验证命令通过 + 独立评审 PASS」后才允许完成,模型无法自证。
系统构成
- 无框架依赖的 TypeScript 核心(
src/agentos/):运行时、编排器、Agent、工具运行时、事件总线、检查点/恢复、验证引擎、任务队列、指标 - CLI(
bin/agentos.js)+ Next.js 仪表盘(任务、实时事件时间线、Agent、工具、测试、指标,PostgreSQL 支撑) - 双层持久化:离线用 JSONL + SQLite(
node:sqlite),仪表盘用 PostgreSQL(Drizzle ORM) - 测试体系:单元 / 集成 / e2e / 恢复 / 压力 / 混沌 六类套件 + 基准测试
关键设计
1. Agentic 模式(tool-calling 主循环)
对齐 Claude Code / Codex 的核心范式:模型每轮提出工具调用、观察结构化结果、自主决定下一步,直到宣称达成目标。 关键在于 harness 始终掌权——预算、每次调用的检查点、验证引擎与独立评审员依然用客观证据把守完成闸门。
模型输出实时流式下发:文本增量以瞬时 model.delta 事件扇出(从不持久化),由 task run 与 chat 内联渲染。
长任务通过自动压缩(LLM 摘要旧轮次,无模型时退化为确定性标记)保持在上下文窗口内。
项目指令从 AGENTS.md(或 CLAUDE.md / AGENTOS.md)注入系统提示。
export LLM_API_KEY=sk-...      # 需要原生 tool calling(OpenAI 兼容接口)
./bin/agentos.js task run --mode agentic \
  --goal 'add a REST endpoint /health to src/server.ts with a test'

# 交互式会话
./bin/agentos.js chat           # confirm 模式:每个工具调用都询问 (y/N)
./bin/agentos.js chat --auto    # 不询问(策略与 hooks 仍然生效)
2. 分级沙箱
Shell 命令(终端工具 + 验证引擎)可运行在可插拔沙箱中:
| 模式 | 说明 |
|---|---|
container | 每条命令跑在临时 Docker 容器:工作区挂载到 /workspace、无网络、降权、内存/CPU/进程数封顶。Docker 不可达时按 onUnavailable 降级而非直接失败 |
process | POSIX ulimit 叠加虚拟内存/进程/CPU 上限;Windows 上失败即关闭(SANDBOX_UNAVAILABLE),除非显式降级 |
none | 仅策略层(拒绝名单 + 工作区路径守卫),历史默认 |
安全边界说明(项目 SECURITY.md 原文立场):沙箱用于兜住意外,而非对抗恶意攻击者。
3. 密钥保险库
agentos secrets set LLM_API_KEY      # --value 或管道输入
agentos secrets list                 # 仅显示名称
agentos secrets get LLM_API_KEY      # 掩码显示,加 --show 才明文
agentos secrets delete LLM_API_KEY
.agentos/secrets.json 使用 AES-256-GCM 加密,主密钥存放于 .agentos/secret.key(0600)或 AGENTOS_SECRET_KEY(64 位十六进制)。
解析顺序:config.llm.apiKeySecret(保险库)→ 供应商环境变量 → 保险库默认条目;agentos doctor 只显示解析到的名称,绝不打印值。
4. 无 Key 时优雅降级
没有 LLM_API_KEY 时,规划器退化为确定性模式(小型目标 DSL 或显式 steps);
有 Key 时由 OpenAI 兼容模型自由规划、提出修复并额外执行独立评审。
两种模式下,任务都只能凭客观证据(验证命令 + 评审员 PASS)完成——这是贯穿全项目的设计红线。
✅ 实机运行记录
我在隔离环境中安装依赖、初始化工作区,并在无 LLM Key 的确定性模式下真实跑通了任务全流程。
① 环境自检(agentos doctor,12 项全通过)
Initialised /tmp/agentos-demo/.agentos (store: sqlite)

✓ node         node 22.22.3
✓ dataDir      /tmp/agentos-demo/.agentos writable
✓ persistence  sqlite store, 0 events, 0 tasks
✓ git          rootDir is not a git repository (git tool still available)
✓ shell        GNU bash, version 5.2.15(1)-release
✓ model        no LLM configured — deterministic planner only
✓ sandbox      none (policy + workspace guard only)
✓ secrets      no vault (.agentos/secrets.json absent)
✓ hooks        no hooks configured
✓ mcp          no MCP servers configured
✓ interrupted  no interrupted tasks
✓ eventBus     seq=0 pending=0 dropped=0 persistErrors=0
All checks passed
注意 ✓ model no LLM configured — deterministic planner only 这一行——
它印证了「无 Key 时优雅降级」的设计:环境自检明确告知当前处于确定性规划模式,而不是报错退出。
② 真实工具注册表与 Agent 角色(tools list / agent list)
filesystem — Sandboxed filesystem access limited to the task workdir
    read / write / append / edit / apply_patch / delete / move / copy
    list / search / mkdir / stat / exists
terminal — Run shell commands (bash) inside the task workdir
    execute(command, cwd?, timeoutMs?, input?, maxOutputBytes?, env?)
    start / poll / stop
process — Inspect and control background processes started by this runtime
    (never arbitrary PIDs)
    list / kill / wait / output
git — Safe git operations (no shell, no force-push, no history rewriting)
    status / diff / log / branch / checkout / add / commit / stash
    init / rev_parse / state / worktree_add / worktree_remove / merge

planner     规划:把任务规格转成可执行步骤计划 (spec → DSL → model)
researcher  检查工作区:文件、包脚本、git 状态、建议的验证方式
executor    通过工具运行时执行步骤,带预算、重试与检查点
tester      运行验证引擎(测试/lint/typecheck/build/自定义)并记录证据
reviewer    独立评审:需求、实现、测试、安全、边界、架构、回归
debugger    诊断失败、归类根因、提出修复步骤或判定终态失败
integrator  合并隔离 worktree 结果;冲突时回滚
③ 成功路径:四个 Agent 角色接力
task.queued        {"status":"QUEUED"}
task.started       {"attempt":0,"phase":"PLANNING"}
planner   agent.started / task.planned  {"source":"spec","steps":1}
executor  agent.tool_call filesystem → tool.completed filesystem 3ms
task.verifying     {"from":"EXECUTING"}
tester    test.started  verification  {"command":"test -f src/health.txt"}
tester    test.passed   verification  {"exitCode":0}
task.reviewing     {"from":"VERIFYING"}
reviewer  review.completed  {"verdict":"PASS","issues":[]}
task.completed     {"steps":1,"toolCalls":2}

task_mvaz9jcv_a4610aec  COMPLETED  p0  写入健康检查端点文件
completed: review PASS with verification evidence
④ 对照实验:验证闸门是不是摆设?
我故意让验证命令指向一个永远不会被创建的文件, 看程序敢不敢因为「执行步骤成功了」就判 COMPLETED。
executor  tool.completed  filesystem 4ms        ← 写文件这一步其实成功了
task.verifying     {"from":"EXECUTING"}
tester    test.failed  verification  ✗ exit=1   ← 验证命令真实执行并失败
task.fixing        {"from":"VERIFYING"}
debugger  task.diagnosed  {"category":"verification","retryable":false,
                           "rootCause":"verification failed: verify-1 exit=1"}
task.failed  ✗ UNRECOVERABLE: verification failed: verify-1 exit=1

task_mvaza5yz_232fa1a7 FAILED p0 验证故意失败的任务FAILED 并进入 FIXING 让 debugger 诊断,
根本没有进入 REVIEWING 阶段——没给「评审」发生的机会。
这正是「任务只能凭客观证据完成,模型无法自证」的硬实现,与 README 的主张完全一致。
重点代码:验证闸门的实现
上述行为对应的源码在 src/agentos/orchestrator.ts。
阶段状态机(源码注释原文):
PLANNING → EXECUTING → VERIFYING → (FIXING → VERIFYING)* → REVIEWING → COMPLETED

const PHASE_PROGRESS = { PLANNING: 5, EXECUTING: 20, VERIFYING: 70,
                         FIXING: 75, REVIEWING: 90, COMPLETED: 100 };
VERIFYING 阶段——验证全部通过才放行到 REVIEWING,否则转入 FIXING:
case "VERIFYING": {
  cp.verification = (await runAgent(tester, ctx(), undefined)).output;
  await save();
  if (cp.verification.every((v) => v.passed)
      && (cp.acceptance ?? []).every((a) => a.passed)) {
    await setPhase("REVIEWING");
  } else {
    pendingFailure = cp.verification.some((v) => !v.passed)
      ? { kind: "verification", results: cp.verification }
      : { kind: "acceptance", results: cp.acceptance ?? [] };
    await setPhase("FIXING");
  }
  break;
}
REVIEWING 阶段——只有独立评审员给出 PASS,且在隔离 worktree 下合并成功,才算真正完成:
case "REVIEWING": {
  cp.review = (await runAgent(reviewer, ctx(), {
    plan, stepResults: cp.completedSteps,
    verification: cp.verification, acceptance: cp.acceptance ?? []
  })).output;
  await save();
  if (cp.review.verdict === "PASS") {
    if (cp.worktree) {
      const res = (await runAgent(integrator, ctx(), { worktree: cp.worktree, ... })).output;
      if (!res.merged) throw new AgentOSError("MERGE_CONFLICT",
        "integration failed: merge conflict (rolled back)", { details: res.conflicts });
      cp.worktree = undefined;
    }
    await setPhase("COMPLETED");
    break;
  }
  pendingFailure = { kind: "review", review: cp.review };
  await setPhase("FIXING");
  break;
}
这两段代码与上面 ④ 的对照实验输出逐行对应:
验证失败 → setPhase("FIXING")(日志里的 task.fixing + debugger 诊断);
评审 PASS → setPhase("COMPLETED")(日志里的 task.completed)。
代码与运行行为一致,不是文档自述。
clihive
github.com/laolaola278-dev/clihive
解决什么问题
同时跑多个 CLI Agent(codex / claude / opencode)时,最大的痛点不是"能不能跑",而是消息到底有没有送达。 多个终端窗口各自为战,你发了一条指令,无法确认目标 Agent 是否真的收到、是否已执行。 clihive 把这件事变成可观测的:所有消息落到一条共享记录上,每次投递都被完整追踪。
架构
┌─────────────────── titlebar (36px) ───────────────────┐
├──────────┬──────────────────────────┬─────────────────┤
│ sidebar  │  toolbar: + pane · mode  │ Fleet · 3       │
│  240px   │                          │ ● p1 cli-1 work │
│ work-    │  ┌────────┐ ┌────────┐   │ ● p2 cli-2 idle │
│ spaces   │  │ cli-1  │ │ cli-2  │   │ ● p3 cli-3 2新  │
│          │  ├────────┤ ├────────┤   ├─────────────────┤
│          │  │ cli-3  │ │ cli-4  │   │ Orchestrator    │
│          │  └────────┘ └────────┘   │ chat|shared|trace│
│          │    hero terminal grid    ├─────────────────┤
│          │                          │ composer → all  │
├──────────┴──────────────────────────┴─────────────────┤
│  activity trace drawer (Ctrl+Shift+T)                 │
└───────────────────────────────────────────────────────┘
核心实现
- 真实 PTY,不是模拟终端。 每个窗格是一个真实的伪终端,跑你的 shell 或 Agent CLI。
- 按命令行自动识别 CLI 类型。
src/server/cli-profiles.js识别 codex、claude、gemini、qwen、aider、opencode、cline、amp、goose、dsh、shell、node、python 等 13 类,窗格自动带上对应徽标与主题色。 - 投递策略按 CLI 能力匹配。 从 stdin 读提示符的程序走
stdin投递(行以 CR 结尾,确保 Windows ConPTY 真的把数据交给子进程);shell 和未知工具走非破坏性的display绘制;全屏 TUI 程序绝不喂模拟按键——这类改为以「托管 Agent」方式编排。 - 托管 Agent 走结构化接口。 用
codex exec --json/claude -p --output-format stream-json驱动,一次一个任务,带权限边界;任务跨重启持久化,结果以校验过的 JSON 返回。 - "完成"只表示待评审。 托管 Agent 标记 done 后需运维人员凭证据批准,而非自动放行。
- 投递追踪是可观测性契约。 send → fanout → deliver → ack 全链路记录为 JSONL 并流式推送到追踪视图,每条记录标注通道(channel)、目标(target)、是否落地(ok)。
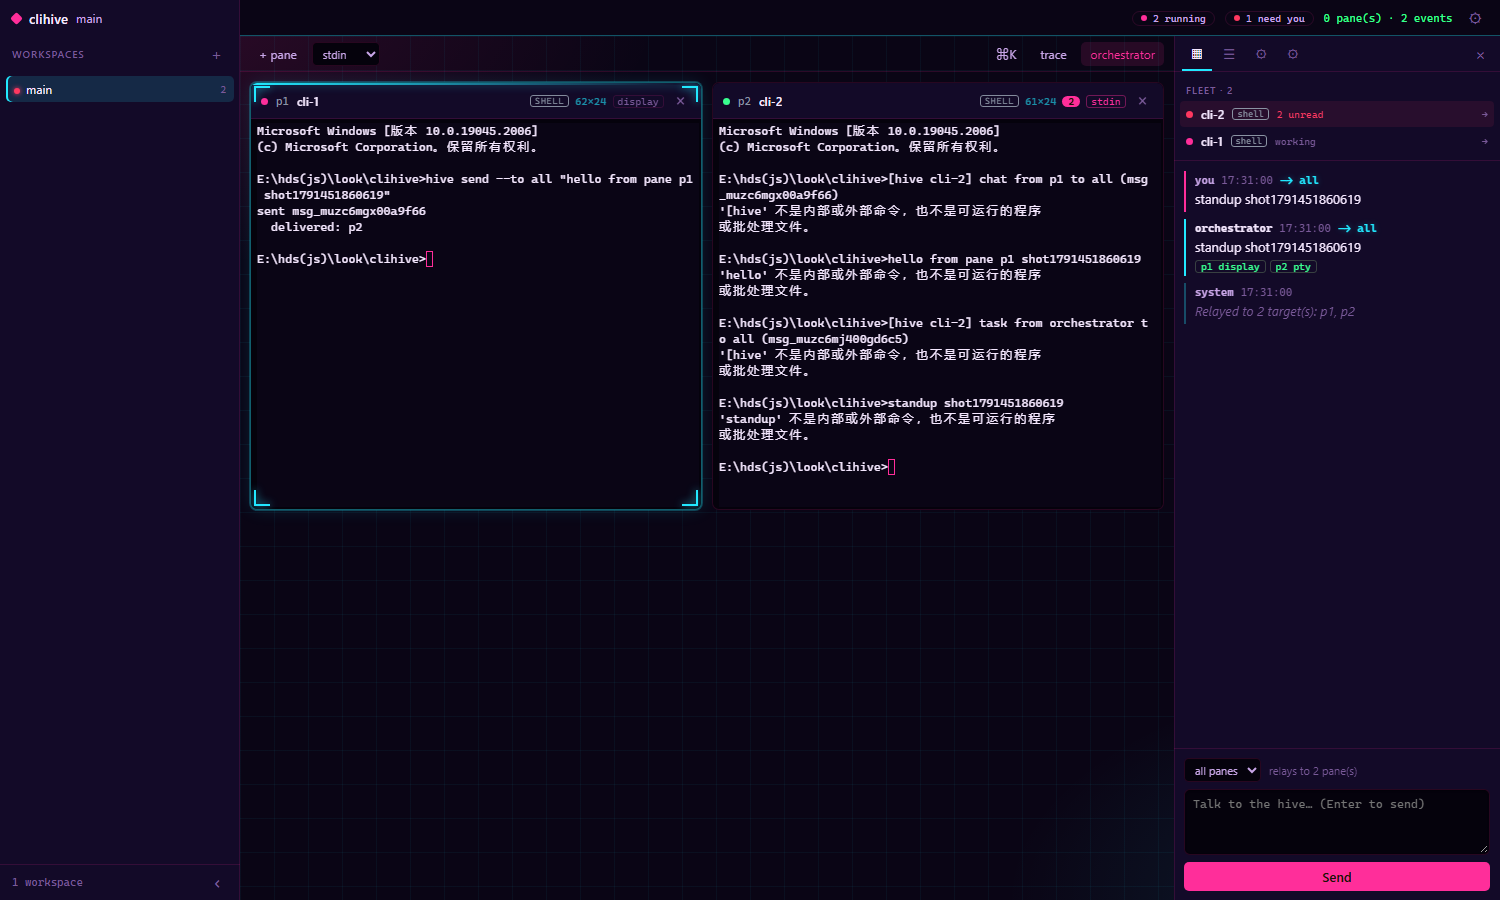
- 窗格间直接对话。 任意窗格内执行
hive send --to all "..."或--to p3,子 Agent 可互相跟进彼此的工作。
运行流程
# 启动服务
npm start

# 在窗格内与其他 Agent 对话
hive send --to all "请先读取 src/server/http.js 再动手"
hive send --to p3 "这个改动补一个回归测试"

# 查看当前身份 / 窗格
hive whoami

# 快捷键
Ctrl/Cmd+J  开关编排器
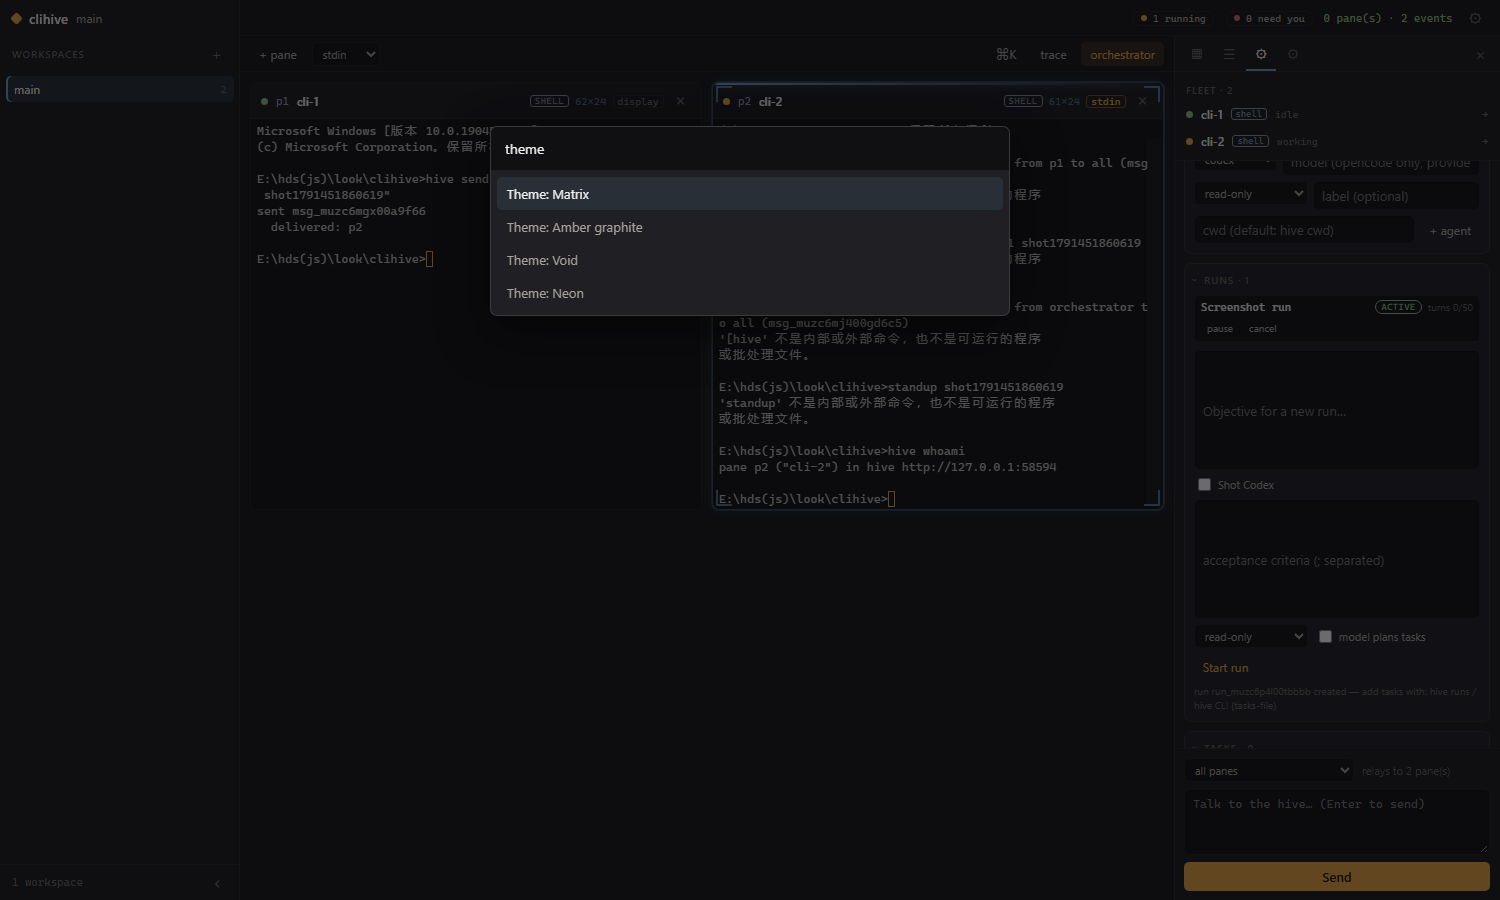
Ctrl/Cmd+K  命令面板
Ctrl/Cmd+B  折叠侧边栏
Ctrl+Shift+T  活动追踪抽屉

# 重新生成全部真实截图(headless Chromium 驱动真实 UI)
npm run screenshots
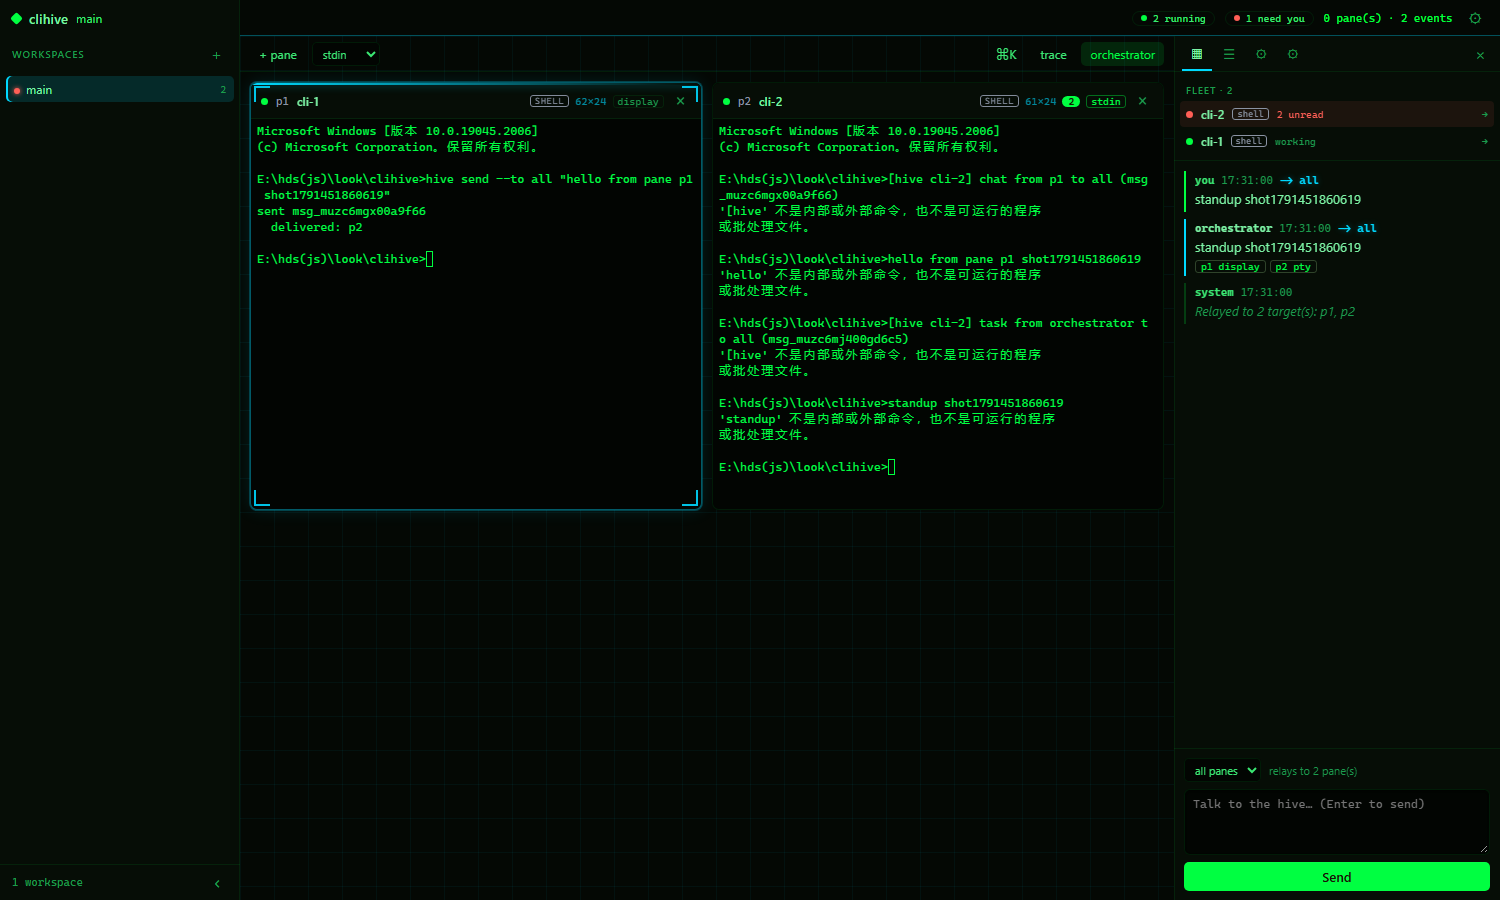
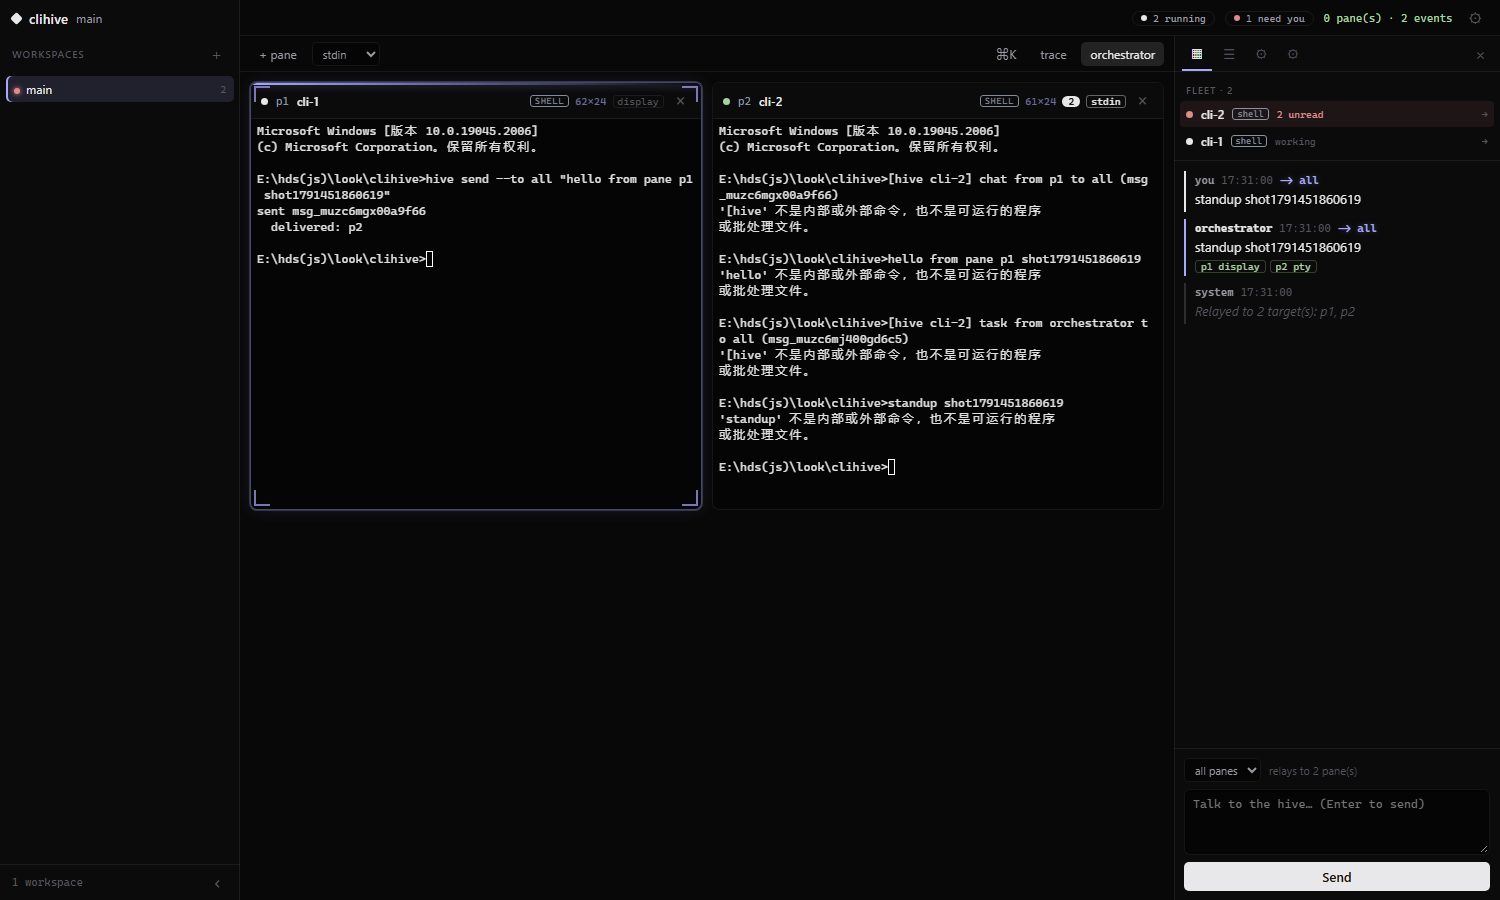
运行实例
screenshots/ 目录,由 scripts/screenshots.mjs 启动真实 HiveServer、
用 headless Chromium 驱动真实窗口、创建真实 PTY 窗格后自动捕获,每一步带 PASS/FAIL 断言,非人工摆拍。
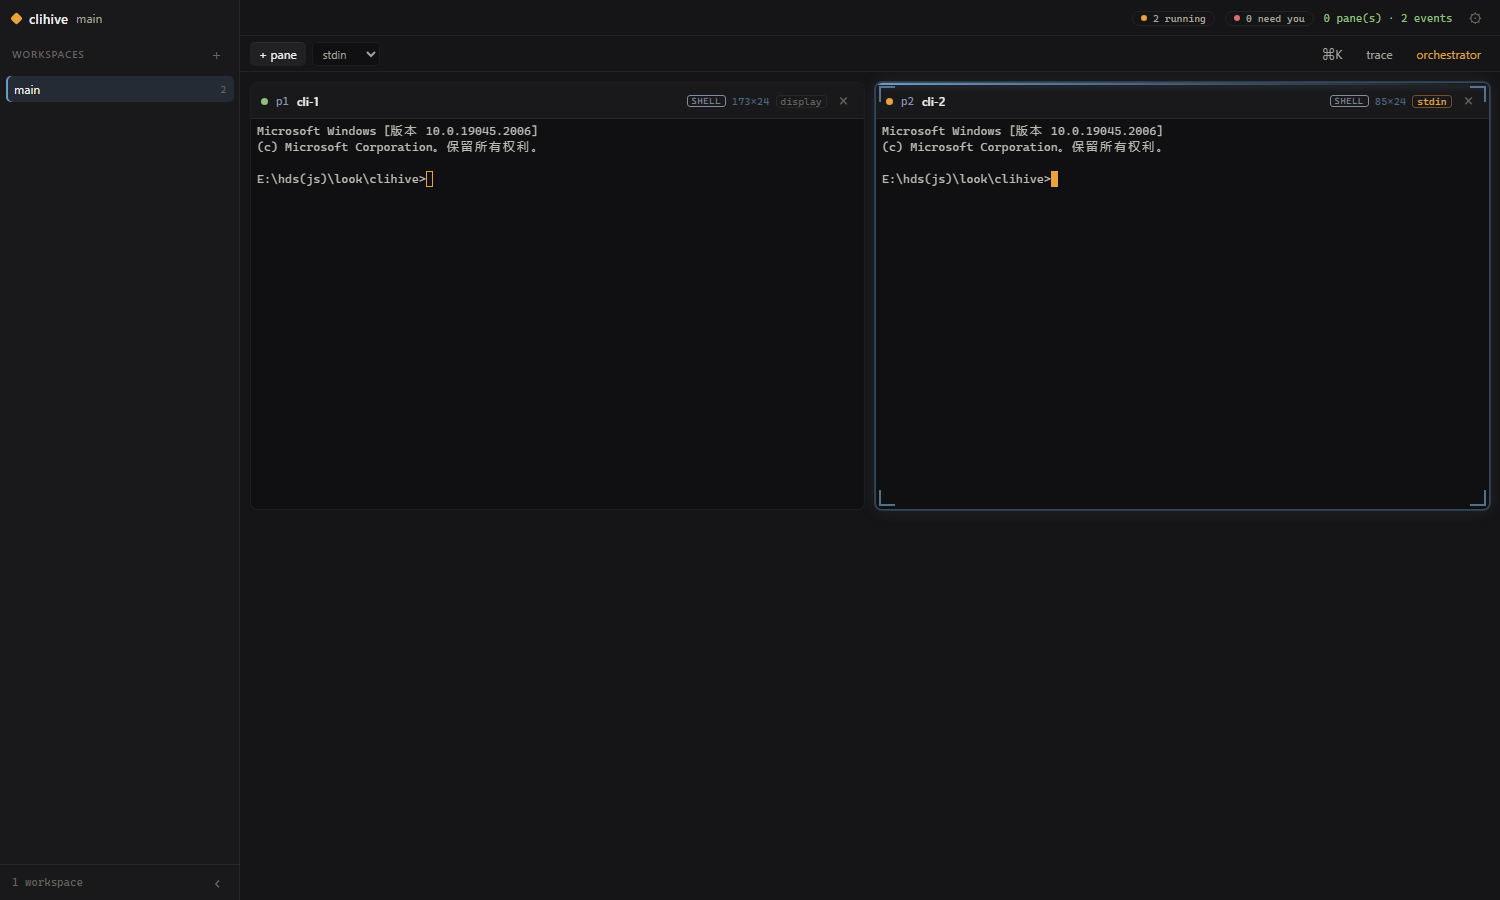
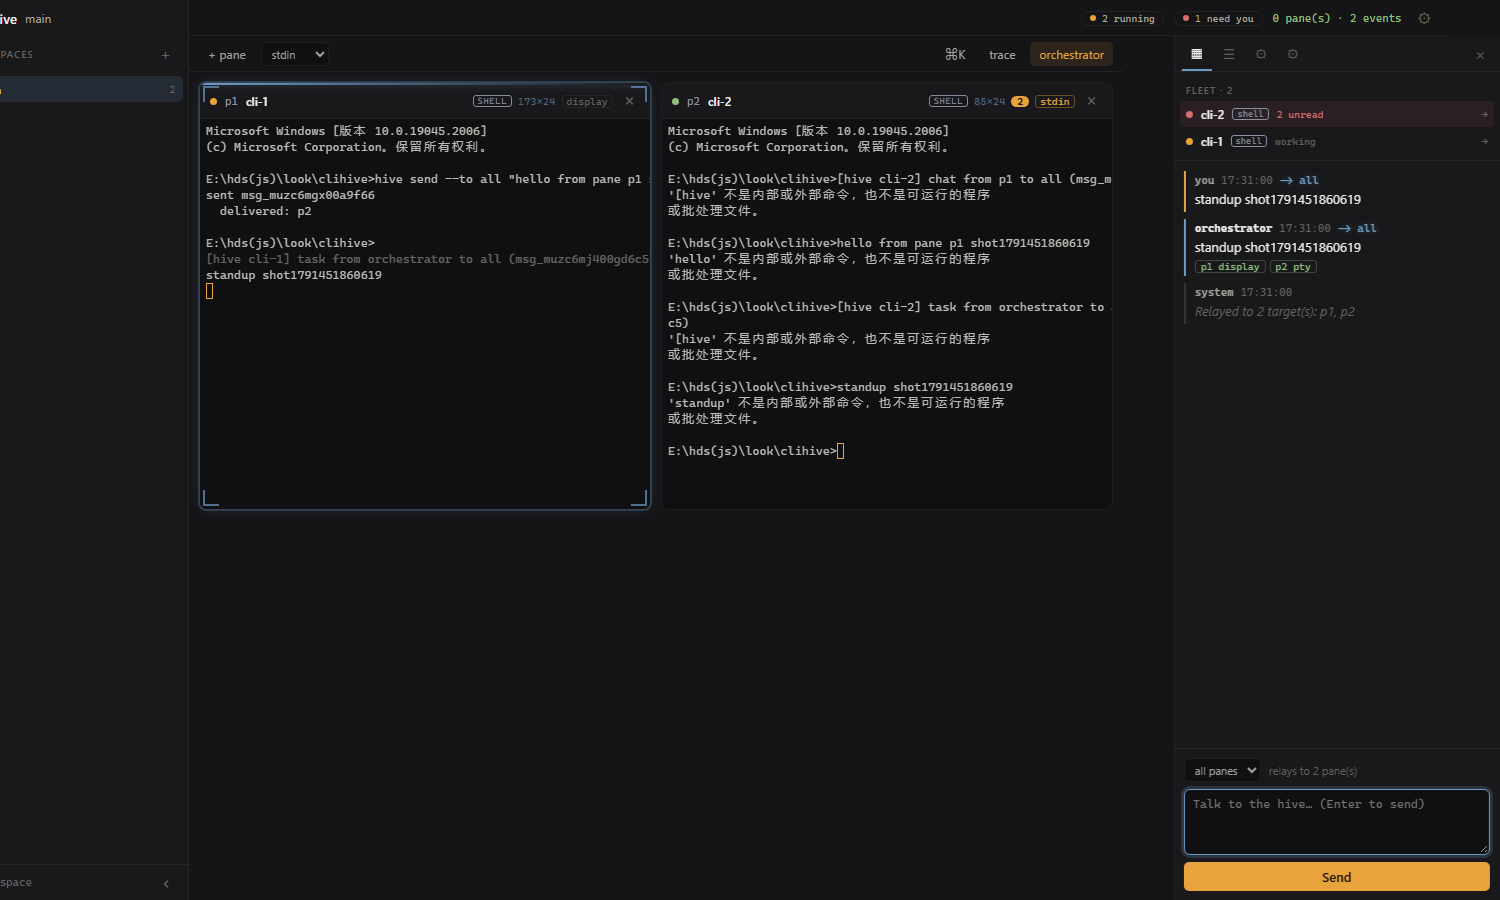
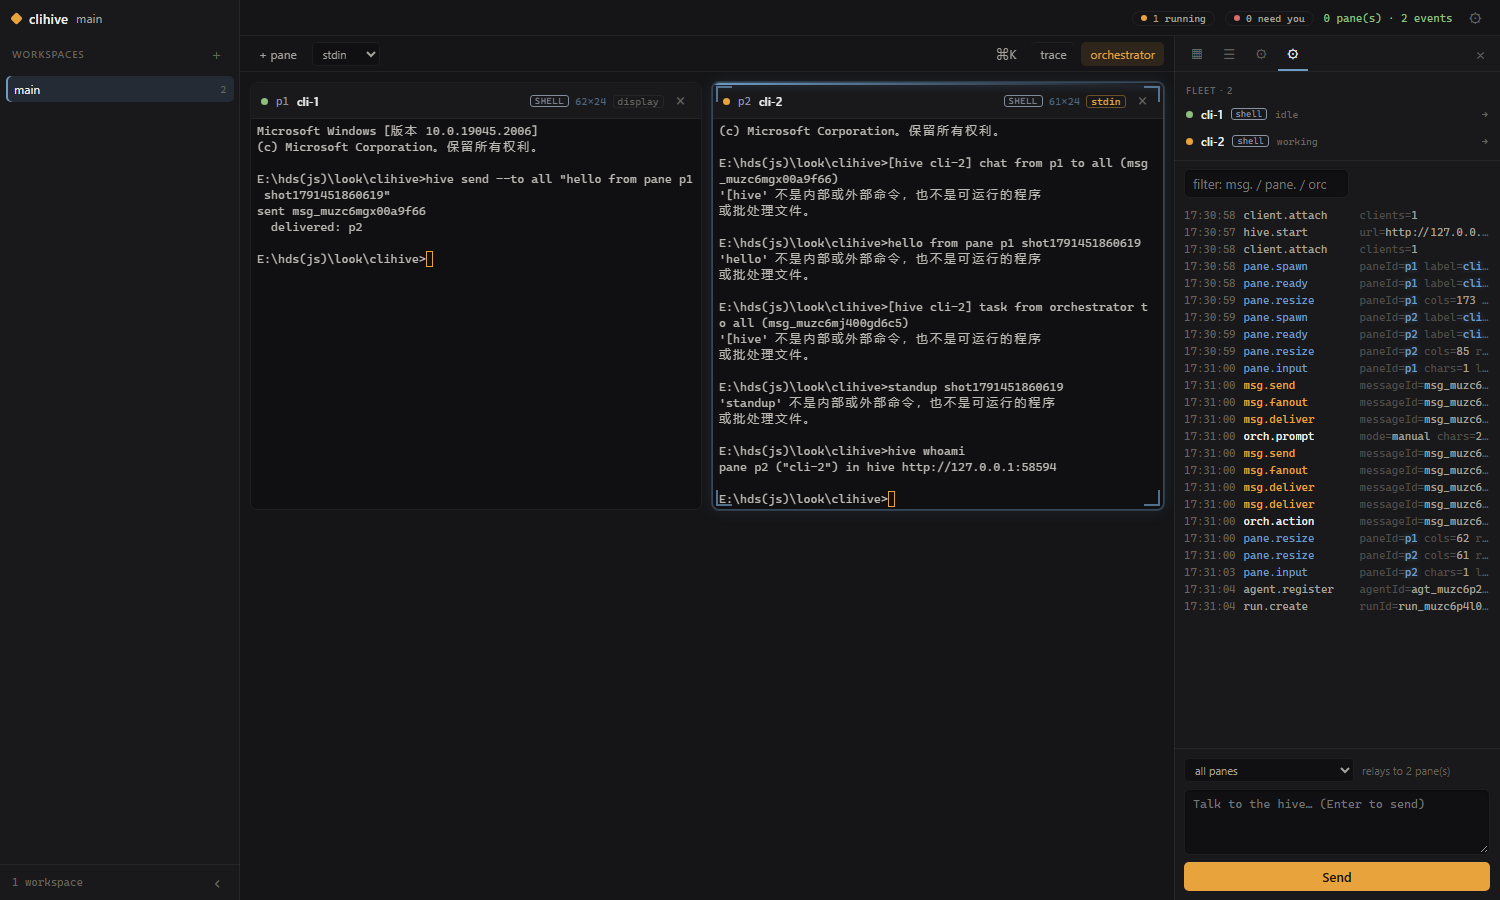
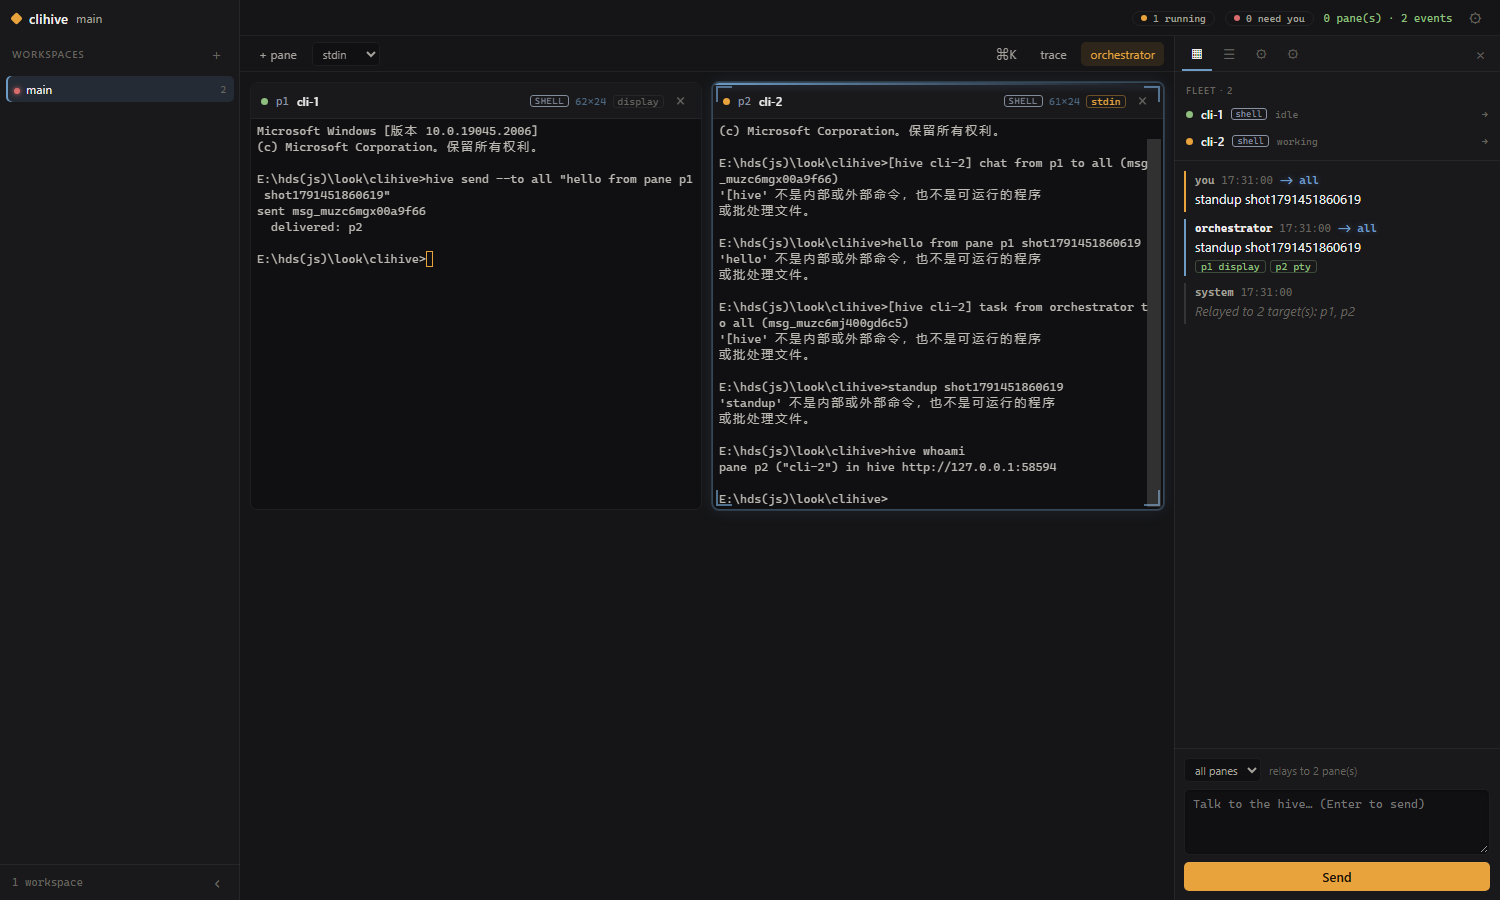
hive whoami 输出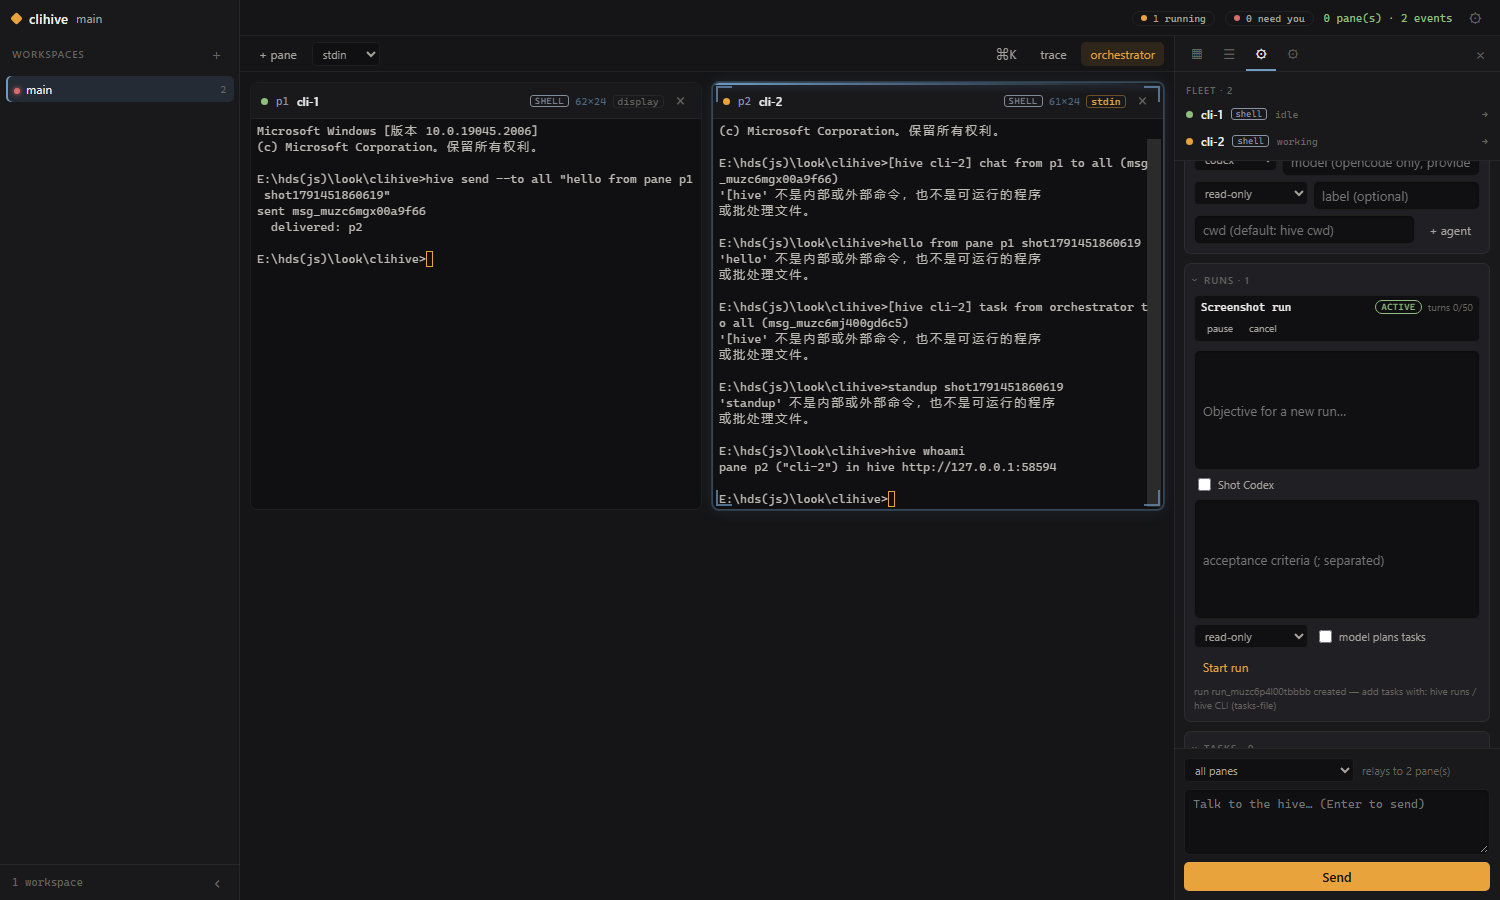
AutoFlow AI
github.com/laolaola278-dev/autoflow-ai
系统架构
┌─ Console(Next.js · React Flow 编辑器 · SSE Agent 控制台 · Dashboard)
│
├─ API(Next.js Route Handlers · 48 路由 · REST + SSE)
│
├─ AI Runtime ───────── Intelligent Model Router ──────── LLM 统一层
│  Planner → Permission Gate     延迟/成本/成功率/质量       chat · stream
│  → Tool Executors(真 RAG)      四维评分 + 策略切换          tool_call
│  → Trace Events(事件溯源)      + 回退链(实弹)              embedding
│                                                           BYOK→env→内置模拟
│
├─ Durable Queue + Worker(Postgres FOR UPDATE SKIP LOCKED)
│  原子租约 · heartbeat 续约 · fencing 写回 · reaper 清过期
│  · 指数退避 · 原子幂等
│
├─ Trace-first Observability(AsyncLocalStorage 零签名埋点)
│  API → Queue → Workflow → Node → LLM → Tool → External 全链 span
│
└─ PostgreSQL(25+ 表 · pgvector-ready · 微美元成本账本 · 审计三线)
核心能力
| 域 | 交付要点 |
|---|---|
| Workflow Engine | React Flow 可视化画布 · 9 类节点(3 触发器 + HTTP/DB/AI Agent/文件/飞书/邮件)· DAG 拓扑调度 · 节点级重试熔断 · 故障演练开关 |
| Durable Execution | 持久化队列 · SKIP LOCKED 原子租约 · heartbeat(TTL/3)· fencing 条件写回 · reaper 恢复 · 4s→120s 退避 · 原子幂等 |
| AI Agent Runtime | Planner(chatWithTools)→ 工具权限(放行/审批/拒绝 + 审计)→ 执行器 → SSE 实时事件(replay + subscribe)→ Trace 落库 → 成本账本 |
| 企业 RAG | 语义切片(360 字)→ 确定性 64 维向量 → 双路径检索(pgvector ivfflat 可用时 / JSONB 余弦回退)→ 引用卡片可溯源 |
| Intelligent Router | 四维实时评分 + 4 策略(cost/latency/balanced/quality)+ 白名单治理 + 失败回退链(≤3 跳)+ 评估质量回灌(人工权重 ×2) |
| Observability | ALS 零签名分布式追踪 · 节点耗时 Gantt · span 瀑布页 · 成本趋势 · 失败节点榜 · 告警(规则/通道/认领/自动解除/去重) |
| Enterprise Security | RBAC 四角色 · BYOK 密钥按租户隔离(掩码展示)· 工具沙箱(风险分级 + 审批门)· 审计三线(logs/events/audits) |
运行流程
git clone <repo> && cd autoflow-ai
npm install
# .env → DATABASE_URL=postgresql://postgres:postgres@127.0.0.1:5432/app_db
npx drizzle-kit push --force          # 零停机的增量 schema
npx tsx scripts/demo/reset-demo.ts    # 灌入演示数据
npm run build && npm start            # → http://localhost:3000

# 按 8 幕剧本走完业务闭环
open docs/DEMO-SCRIPT.md
# 故障演练:LLM 故障 → 路由回退 → 恢复(无损数据,自动清理)
npx tsx scripts/demo/failure-showcase.ts
没有 LLM Key 也能完整验证:内置确定性模拟适配器(带标定延迟),
队列 / 追踪 / 权限 / 计量 / 回退等所有机制真实可验;配置 OPENAI_API_KEY /
MOONSHOT_API_KEY / ANTHROPIC_API_KEY 或工作区 BYOK 即切换到真实模型。
自述性能与可靠性基线
| 报告 | 关键基线 |
|---|---|
| PERFORMANCE | 入队 199 QPS / P50 33.8ms · 单节点 sync P50 309.6ms · AI-DAG P50 2117ms · SSE 40 路 560/560 零丢帧、投递延迟 P50 4ms · 向量 1k@37.7ms |
| RELIABILITY | Worker 崩溃 2.46s 自愈 + 恰好一次 + fencing 0 行 · DB 断供 4ms 恢复 · LLM 5xx/429/timeout 回退三场景全过 · 节点重试 ×3 熔断 |
| PATCH-REVIEW | R-02 存储层原子幂等:100 并发同键 ⇒ 1 job / 99 dedupe / 单执行 · R-01 顶层异常终态化(三层场景零孤儿) |
- 故障演练捕获了 2 个真实缺陷(已修复)——主动暴露问题而非只报喜
- Memory 模块标注为「诚实呈现」:本期仅以评估历史 + 历史 trace 呈现经验召回, 独立记忆子系统列入 Phase 9,透明度原则:不宣称未实现的能力
skillc
github.com/laolaola278-dev/skillc
解决什么问题
你写了一份 Agent Skill,现在要让它同时工作在 Claude Code、Codex、DSH、Hermes、OpenClaw。 朴素做法是复制文件——但各底盘能力不同,复制过去的文件要么 silently 丢失能力(如 cron/trigger), 要么覆盖掉用户的手工改动。skillc 用编译而非复制来解决。
为什么不是复制文件
| 复制文件 | skillc |
|---|---|
| 所有地方都是同一份文本,即便目标底盘根本不具备该能力 | 按目标生成能力 IR;能力缺失时在编译期降级或报错 |
| 不记录自己写过什么 | lockfile + 标记块;拒绝覆盖手工修改 |
| cron / trigger 被静默丢弃 | 显式声明,编译时排除并给出可见提示行 |
使用流程
npm install && npm run build
npm link          # skillc 成为全局命令,任意目录可用

# ① 体检:校验源码 + 各目标兼容性(零写入)
skillc doctor --src examples/deploy-qm/skill.src

# ② 编译为计划(默认不落盘,仅产出 .skillc/plan.json)
skillc build --src skill.src --root <your-project>

# ③ 同步(默认空跑;--write 才真正应用;--force 覆盖)
skillc sync  --src skill.src --root <your-project>           # dry-run
skillc sync  --src skill.src --root <your-project> --write   # apply

# 其他
skillc upgrade --src skill.src --root <dir>        # 版本增量报告 + 应用
skillc pack    --src skill.src -o out.skillpack    # 打包为单文件
skillc unpack  out.skillpack -o ./dir              # 反向导入回源码
实现要点
- 源码解析 → 中间表示(IR)→ 多目标发射器(emitters):已支持 Claude Code、Codex(AGENTS.md 注入)、DSH、Hermes
- Safe sync 锁文件:对写操作分六类——
create/replace/inject-replace/inject-append/unchanged/blocked。绝不覆盖非 skillc 写过的文件,对用户自有文件只在标记块内注入 - 资源打包(M3.5):显式
resources:列表或自动探测,逐字复制到每个目标 skill 目录,缺失引用会给出诊断 - 多运行时 A/B 试用与确定性发现机制
- 随附 gitguard:提交卫生检查工具,可一键安装到所有仓库生效
设计边界(项目自述)
gh skill install 的职责)。
自述验证状态:16/16 测试通过;通过 npm link 提供全局 CLI(任意目录可用);
已在 Codex / Claude Code / Hermes / OpenClaw 上做真实运行时验证(见 docs/TRIAL-*.md)。
✅ 实机运行记录
① 编译:一份源码 → 4 个目标,21 个文件
skillc build — deploy-qm@0.2.0 (ir 985f896daaf3016b)
  · [claude-code] .claude/skills/deploy-qm/SKILL.md (standalone)
  · [claude-code] .claude/skills/deploy-qm/tools/example-tool/tool.json
  · [claude-code] .claude/skills/deploy-qm/deployment.md
  · [claude-code] .claude/skills/deploy-qm/references/fly.md
  · [claude-code] .claude/skills/deploy-qm/references/aws.md
! [codex] "web-fetch" is not native on codex — the emitted text tells
          the agent to ask the user to paste fetched content
  · [codex] .codex/skills/deploy-qm/SKILL.md (standalone)
  · [codex] .codex/skills/deploy-qm/tools/example-tool/tool.json
  · [codex] AGENTS.md (injection)          ← 仅 codex 需要注入式产物
  · [codex] .codex/skills/deploy-qm/deployment.md
  · [dsh]    .dsh/skills/deploy-qm/...     (5 files)
  · [hermes] .hermes/skills/deploy-qm/...  (5 files)
ok 21 file(s) across 4 target(s) -> .skillc/plan.json- codex 目标额外产出了
AGENTS.md (injection),而其他三个目标全是 standalone 文件——产物结构本身就不同 - plan.json 里同一个 SKILL.md 的哈希值各不相同:
claude-code 是
c5723df45b835fce,codex 是34698be136514253。 如果只是复制文件,哈希不可能不同。
② 首次同步:写入 21 个文件并生成 lockfile
+ [hermes] .hermes/skills/deploy-qm/deployment.md
+ [hermes] .hermes/skills/deploy-qm/references/fly.md
+ [hermes] .hermes/skills/deploy-qm/references/aws.md
  wrote 5 file(s) for claude-code
  wrote 6 file(s) for codex
  wrote 5 file(s) for dsh
  wrote 5 file(s) for hermes
ok sync complete; lockfile -> .skillc/lock.json
③ 关键测试:手工改动会不会被覆盖?
这是 skillc 最核心的承诺。我的做法是:往刚生成的 SKILL.md 里手工追加一行注释,
然后再次执行 sync --write,看它怎么处理。
! [claude-code] .claude/skills/deploy-qm/SKILL.md
      — changed outside skillc since the last sync; pass --force to overwrite
= [claude-code] .claude/skills/deploy-qm/tools/example-tool/tool.json
= [claude-code] .claude/skills/deploy-qm/deployment.md
= [codex] .codex/skills/deploy-qm/SKILL.md
= [codex] AGENTS.md
= [dsh] ...   (5 files unchanged)
= [hermes] ... (5 files unchanged)
x refusing to sync: 1 file(s) changed outside skillc
      — resolve them or pass --force

# 随后检查文件内容:
$ grep -c "我手工加的一行" .claude/skills/deploy-qm/SKILL.md
1 ← 手工修改完好保留,未被覆盖x refusing to sync),
而不是自作主张覆盖用户的修改。其余 20 个文件正确标记为 =(unchanged,幂等跳过)。
输出前缀语义:+ 新建 · = 未变更 · ! 外部修改告警 · x 拒绝。
重点代码:三态哈希比对
上面「拒绝覆盖」的判定逻辑在 src/sync.ts。它维护三个哈希:
current(文件当前内容)、file.content(本次将要写入的内容)、
last(lockfile 记录的上次写入内容),用三态比对精确区分「skillc 的旧版本」与「用户的手工修改」:
const current = sha256Text(readFileSync(abs, "utf8"));

// ① 当前内容 == 本次将写入的内容 → 幂等,跳过
if (current === sha256Text(file.content)) {
  actions.push({ target, file, kind: "unchanged" });
  continue;
}

// ② 当前内容 == lockfile 记录的上次写入 → 是 skillc 自己的旧版本,安全替换
const last = targetLock[file.path]?.hash;
if (last && current === last) {
  actions.push({ target, file, kind: "replace" });
  continue;
}

// ③ 两者都对不上 → 用户在 skillc 之外改过,拒绝覆盖(除非 --force)
if (opts.force) {
  actions.push({ target, file, kind: "replace",
    reason: "--force over a file changed outside skillc" });
  continue;
}
actions.push({
  target, file, kind: "blocked",
  reason: "changed outside skillc since the last sync; pass --force to overwrite"
});
这个设计的巧妙之处在于:仅比较「当前 vs 新内容」只能判断要不要写, 却无法判断能不能安全覆盖。引入 lockfile 里记录的第三态后, 才能把「skillc 自己留下的旧版本」(可安全替换)与「用户手改的内容」(必须保护)区分开。
crew-skill
github.com/laolaola278-dev/crew-skill
解决什么问题
三步工作流
npx crew-skill add .             # 创建 .crew/ 并装入你的 agent skill 目录
npx crew-skill distill-git .     # 扫描 git 历史 → 5 份有证据支撑的 SKILL.md
npx crew-skill check . --agent   # 上岗考试 + 成绩单

# 输出:300 commits → 5 skills · 19 rules · 1.86s
# 全程无账号、无配置、无网络add—— 创建.crew/,并把 skill loader 装进你的 Agent 技能目录(.claude/skills、.agents/skills、.cursor/skills)distill-git—— 扫描 git 历史、给 commit 分类,产出 5 份 SKILL.md:naming(命名)、review(评审关注点)、testing(测试习惯)、runbook(部署手册)、gotchas(坑)check—— 生成上岗考试题并打分,输出成绩单(.md+.html)
✅ 实机运行记录
我在隔离环境中安装依赖、完成构建,并对一个真实的 16-commit 仓库(agentos)跑通了
蒸馏 → 考试两步。
① 蒸馏(distill-git)
crew-skill · distill-git · agentos-full
scanned 16 commits  ·  wrote 5 skills → .crew/skills/
time split: T=2026-06-25 (auto, latest-90d)  ·  0 training + 16 exam-window commits
  naming.md      3 rules · Naming Conventions
  review.md      1 rule · Review Focus
  testing.md     3 rules · Testing
  runbook.md     1 rule · Runbook / Deploy
  gotchas.md     1 rule · Gotchas
  dropped 1 rule (no evidence)

PR reviews: skipped — default is 100% local
  (re-run with --with-pr to fetch GitHub review comments)
dropped 1 rule (no evidence) 这一行是关键。
它证明「无证据的规则会被丢弃、且丢弃数如实报告」不是文档措辞,而是真实执行到的代码路径。
同时 PR reviews: skipped — default is 100% local 也印证了隐私设计:默认绝不联网。
② 生成的规则长什么样(naming.md 实测产出)
## Rules
1. **16/16 conventional commits (last 16 commits,
   regex ^(feat|fix|docs|style|refactor|perf|test|build|ci|chore|revert|merge|release)...).**
   — Evidence: daaa216 "feat(agentos): close parity gaps in search, context, subagents..."
2. **Preferred commit types: feat 11, chore 2, fix 2, docs 1.**
   — Evidence: 7bbcb0b "feat(dashboard): web approval gate + conversational /chat page"
3. **File naming: kebab-case (10%) (120 source-like files: kebab 12, snake 1, camel 0).**
   — Evidence: src/app/components/approval-toaster.tsx

## Anti-patterns (real)
- (none found in the scanned window — absence is not proof;
   verify the relevant commands yourself)
每条规则都挂着真实 commit 哈希或文件路径。另一份 testing.md 里甚至精确到了
文件行号:Mocking/stubbing is used in tests (e.g. tests/integration/agentic.test.ts:5)。
更值得说的是最后那句自我限定——absence is not proof(没有找到反例,不等于不存在反例),
以及页脚的 heuristic, not AI — verify before acting。
它明确告诉使用者这是启发式规则而非 AI 推理,行动前请自行验证。
③ 上岗考试(check --agent)
┌─────────────────────────────────────┐
│ CREW CHECK · onboarding exam        │
│ repo: agentos-full  (skills loaded) │
│                                     │
│ SCORE 40 / 100                      │
│ naming  ●●●●● 19/20                 │
│ process ●●●○○ 10/20                 │
│ deploy  ●○○○○  4/20                 │
│ gotchas ●●○○○  7/20                 │
│ docs    ○○○○○  0/20                 │
│                                     │
│ verdict: not ready                  │
└─────────────────────────────────────┘
weakest area: docs (0/20)
原因不神秘:README 的 67/100 是在 pi 仓库(300 commits)上测得,
而我用的是 agentos(16 commits),且本次时间切分结果为
0 training + 16 exam-window commits——训练窗口内没有 commit,可蒸馏的素材本就少得多。
两者测的不是同一件事,不构成矛盾。
但我觉得这个"难看的结果"反而更值得放上来:工具面对素材不足的情况,
诚实给出了 verdict: not ready 和 40 分,而不是为了好看去凑一个高分。
这比复现一个漂亮数字更能说明它的可信度。
⭐ 两条我认为最值得说的设计
1. 证据门槛:没有证据的规则,宁可丢掉
每条被提炼出的规则都必须携带真实来源(具体的 commit / 文件)。 找不到证据的规则会被直接丢弃,而且丢弃的数量总是被如实报告出来。 这一点很罕见——大多数同类工具会想方设法多产出几条规则让结果好看, 而它选择让「我提炼不出可靠规则」这件事本身可见。
2. 时间切分:评估不会自欺欺人
评估方法是:只用 cutoff 时间 T 之前的 commit 做蒸馏, 然后用 T 之后的 commit 构建考题,让全新的 Agent 去答。 这样就避免了「用训练数据当考题」的泄漏问题。 项目原文还说了一句:No cherry-picking — ugly numbers published too.(不挑数据,难看的数字也照发。)
自述基准数据
| 仓库 | 类型 | Commits | Skills·Rules | 安装前 | 安装后 |
|---|---|---|---|---|---|
| pi | engineering (TS) | 300 | 5 · 19 | 0/100 | 67/100 |
| superpowers | docs-heavy (MD) | 681 | 5 · 5 | 0/100 | 57/100 |
第三个仓库(TencentDB-Agent-Memory,中文项目)用于记录中文语料的评测集,项目说明中未对其发布前后对比数据,
只发布前两个仓库的实测数字。用时方面:distill-git 在 300-commit 仓库上 1.86s(3 次计时取中位数,工具自报 0.8s)。
注:以上为项目自述数据,我未在构建环境中复跑验证。
隐私与兼容
- 100% 本地:全部蒸馏都是在本机跑的确定性启发式规则,无遥测、无分析、无更新检查
- 唯一的网络路径默认关闭:只有 LLM 精修钩子(
src/distill/llm.ts)具备联网能力, 且仅在你主动设置CREW_LLM_API时激活——当前里程碑中它是文档化的空实现(仅接口) - PR 评审注释按需拉取:
--with-pr才通过gh抓取,不加参数绝不外取 - 兼容:Claude Code(
.claude/skills)、AGENTS.md 系(Codex 等,.agents/skills)、Cursor(.cursor/skills),Node.js ≥ 18
api-health-checker
github.com/laolaola278-dev/api-health-checker
解决什么问题
手上有一批大模型 API Key,哪些还能用?延迟多少?可用模型列表是什么? 手动一个个试很痛苦。本项目把这件事做成批量、并发、可追溯的服务。
核心实现
- 统一 Provider 抽象(
app/providers/):OpenAI、Anthropic、Google、DeepSeek、Moonshot 各自实现,外加任意 OpenAI-compatible 端点 - 并发批量检测:
BATCH_MAX_CONCURRENCY控制并发度 - SSRF 防护:拦截内网/私网地址,可单独放行 localhost 便于本地开发
- 密钥全程掩码:存储与展示均为
sk-f...7890形式,检测历史落库可追溯 - 认证中间件:
/api/*需X-API-Key头,密钥为默认值时启动即告警
运行流程
pip install -r requirements.txt
cp .env.example .env      # 配置 DATABASE_URL / API_AUTH_ENABLED 等
python main.py            # → http://localhost:8000

# 接口一览(实机验证,共 14 个端点)
GET  /              Web 仪表盘
GET  /history       历史记录页
GET  /docs          Swagger 交互式文档
POST /api/check/key          检测单个密钥
POST /api/models/{provider}  列出可用模型
POST /api/speed-test         速度测试
POST /api/batch-check        批量并发检测
POST /api/compatible-check   兼容端点检测
GET  /api/health / /api/providers / /api/dashboard
GET  /api/history  / DELETE /api/history/{id}
✅ 实机运行记录
服务启动(真实日志):
INFO:     Uvicorn running on http://0.0.0.0:8000 (Press CTRL+C to quit)
INFO:     Started reloader process [1899] using WatchFiles
INFO:     Started server process [1909]
INFO:     Waiting for application startup.
2026-10-16 12:32:46,605 - main - INFO - Starting API Health Checker v1.1.0...
2026-10-16 12:32:46,607 - main - INFO - Database initialized.
INFO:     Application startup complete.
调用 GET /api/health 与 GET /api/providers(真实返回):
{
    "status": "healthy",
    "service": "api-health-checker",
    "version": "1.1.0",
    "timestamp": "2026-10-16T12:33:01.853583+00:00"
}

{
    "providers": [
        "openai", "anthropic", "gemini",
        "deepseek", "moonshot", "openai_compatible"
    ]
}
输入校验生效(传入不存在的 provider,被正确拦截):
POST /api/check/key  {"provider":"nonexistent","api_key":"sk-test"}

{
    "provider": "nonexistent",
    "status": "failed",
    "message": "Unsupported provider: nonexistent",
    "models": []
}All connection attempts failed、TLS/SSL connection has been closed)。
这说明两点:工具确实被真实使用过(才会留下历史), 但成功路径(happy path)并未被真实流量验证过——受网络环境限制,我这次实机验证也只覆盖了健康检查、 Provider 列表、历史查询与输入校验等路径,未能完成一次真正连通外部大模型的成功检测。 此处如实说明,不夸大验证范围。
Doubao WPlus
github.com/laolaola278-dev/doubao-wplus
Release DeepSeek++ 0.4.0 ~ 0.4.3 等提交),
我在此基础上做了 16 个提交,把单宿主的 DeepSeek 插件改造为多宿主的豆包工作台。
我核对过提交记录,改造工作包含真实的技术内容,而非简单换品牌名——详见下方「我做的改造」。 之所以写清楚这一点,是因为把它说成完全独立开发是不诚实的,但把它藏起来又会低估实际做的工作。
⭐ 我做的改造:HostAdapter 多宿主抽象
上游项目是为 DeepSeek 单宿主写的,宿主逻辑散落在各处、直接硬编码。 我做的核心工作是把这部分抽成 HostAdapter 抽象层,让插件能同时支持豆包与 DeepSeek 两个宿主。
| 我的提交 | 做了什么 |
|---|---|
feat(architecture) | 新增 no-host-hardcoding 守卫测试 + HostAdapter 批次改造(content.ts) |
docs(phase1) | 标记 HostAdapter 抽象完成,配套架构守卫 |
feat(chat) | 侧边栏会话改为走豆包 Web session 路由 |
chore | 剥离旧品牌兼容层,接入 e2e runner |
fix(ci) ×3 | 恢复质量闸门脚本、对齐基线、修正可执行位与 prompt-freeze 锚点 |
功能矩阵
- 侧边栏对话 —— 在豆包网页内直接发消息,支持流式渲染;可选配置官方 API Key 后在任意网页使用
- 类原生工具调用 —— 联网搜索、网页读取、工具结果展示
- MCP 工具系统 —— 接入 MCP 工具链
- 记忆系统 —— 四类记忆:用户画像
user、行为反馈feedback、话题上下文topic、参考资料reference - Skill 技能系统 与系统提示词预设
- 浏览器控制 —— 在用户开启的边界内读取页面结构、执行可见操作
- 自动化任务 —— 定时执行、持续执行能力
- 对话导出 与项目上下文产物下载(脚本 / Markdown / JSON / HTML 单文件)
- OfficeCLI 文档工具 —— 集成本地单二进制,含「拒绝额度生成路径」的保护逻辑
- 中英文体验 —— 侧边栏、右键菜单、工具结果、续跑提示保持一致语言,同时保留用户自定义内容原文
工程边界(项目自述)
项目明确说明:豆包为第一优先级宿主,同时兼容 DeepSeek 网页版; 支持 Chrome / Edge / Firefox 三浏览器,并提供 Android WebView 开发者基线。 本地优先,数据留在本地。
GPT++ (newgpt)
github.com/laolaola278-dev/newgpt
解决什么问题
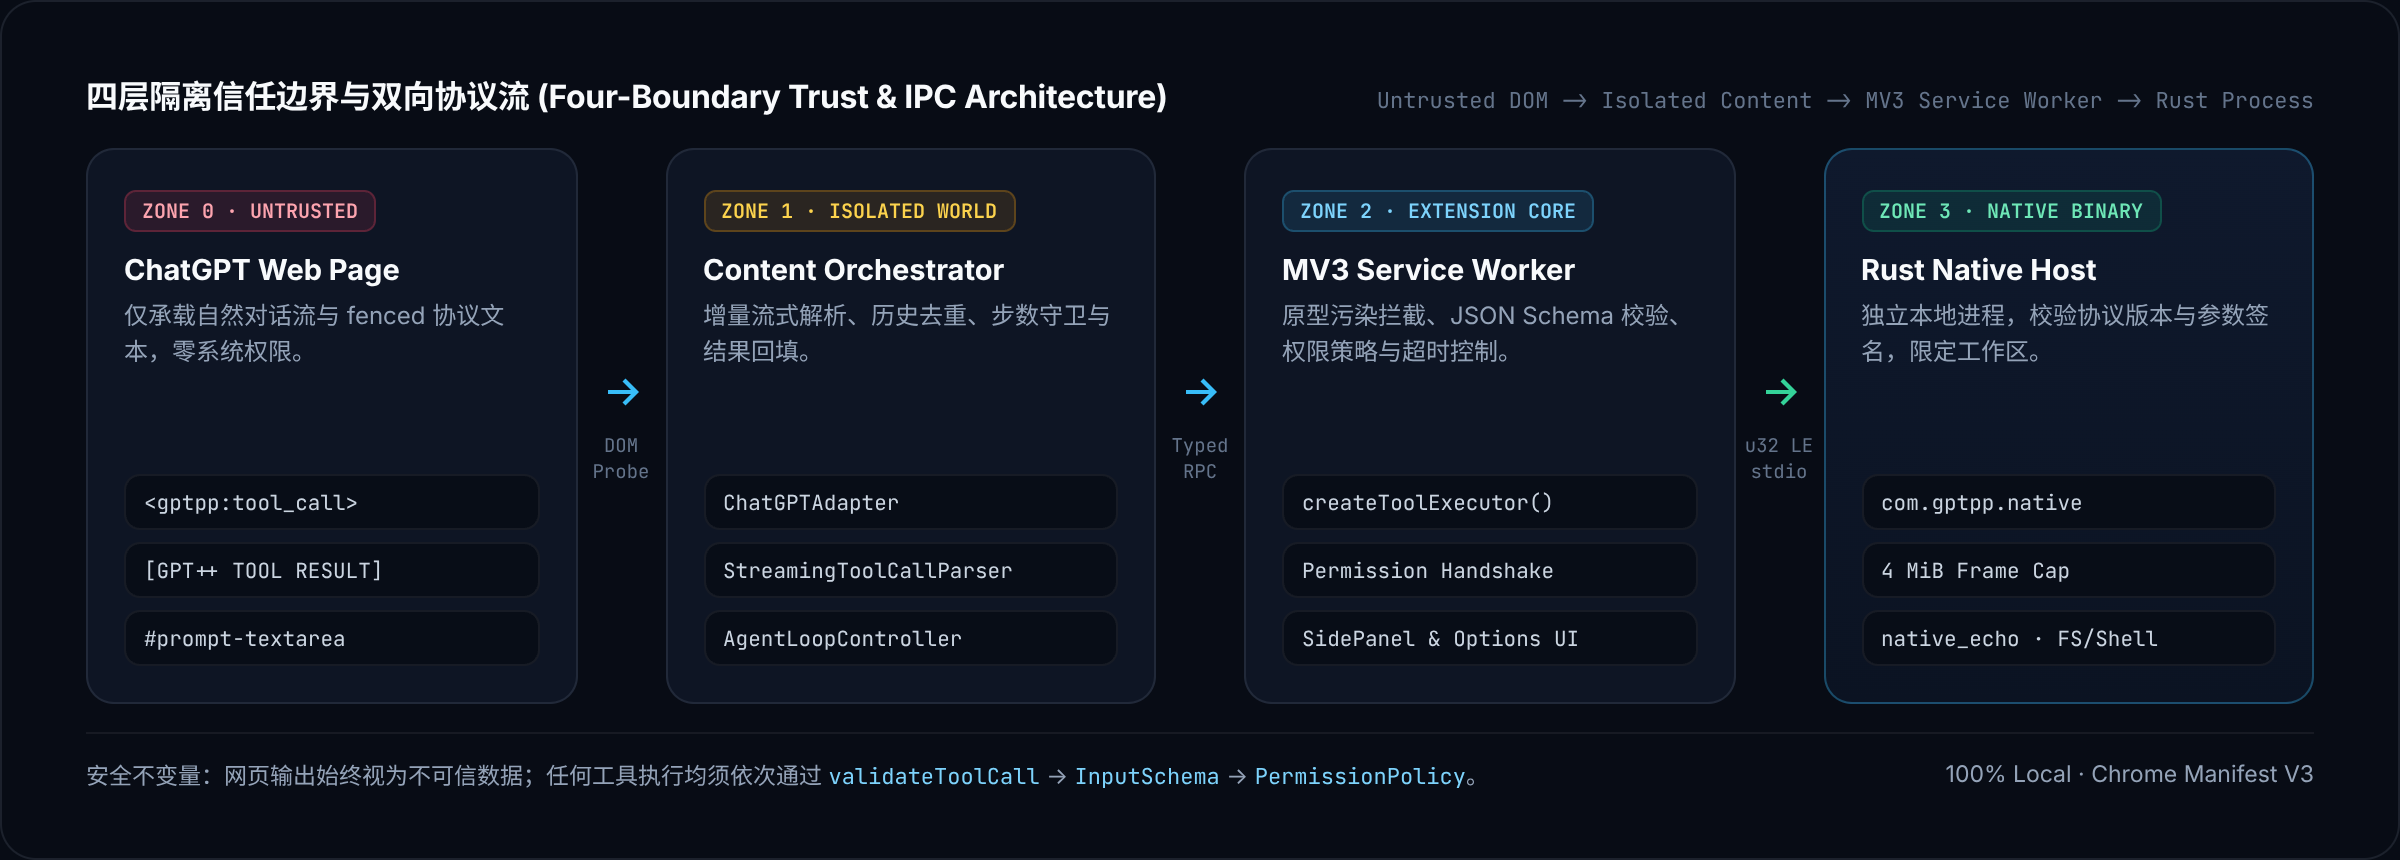
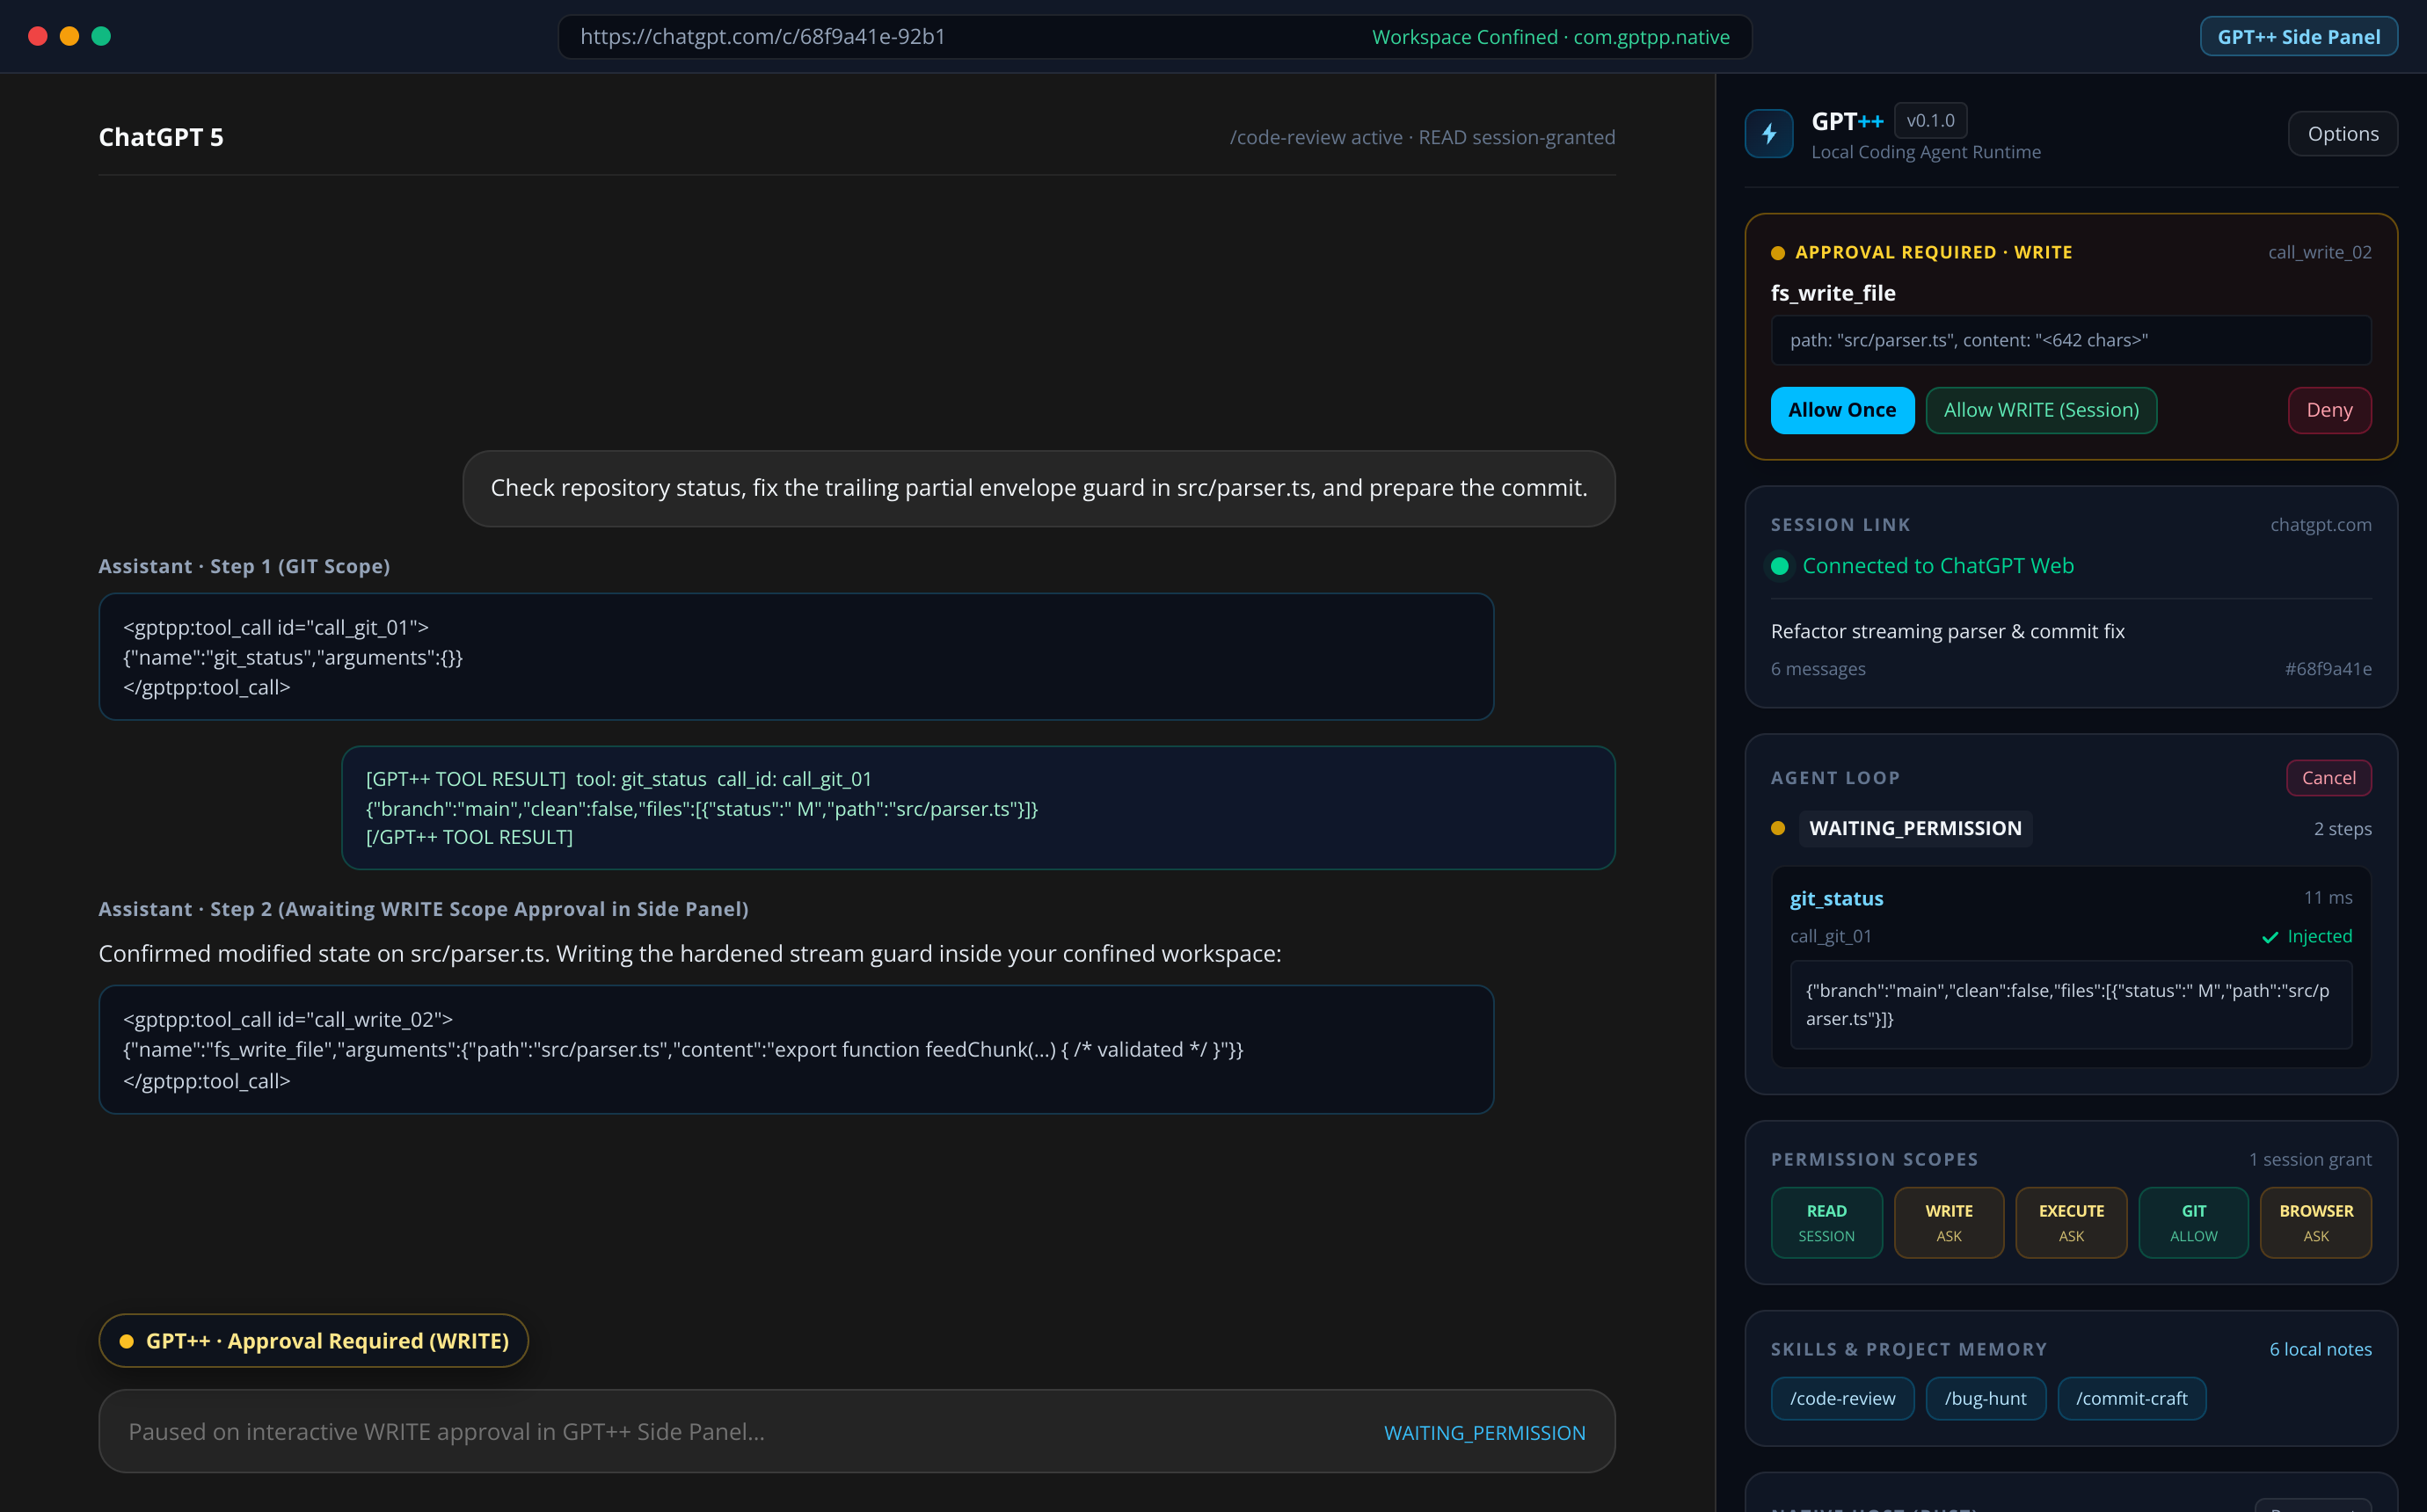
网页版 ChatGPT 好用,但它碰不到本地环境——读不了工作区文件、跑不了命令、看不了 git 历史。 市面上的方案要么要求把 API Key 交给第三方中转,要么把代码传到云端。 GPT++ 的做法是:在浏览器隔离上下文与本机原生进程之间建立一条 强类型、工作区沙箱隔离、五域权限门控的双向通道, 无后端服务、无遥测上报,所有状态、项目记忆与权限配置 100% 留存在本机。
系统构成
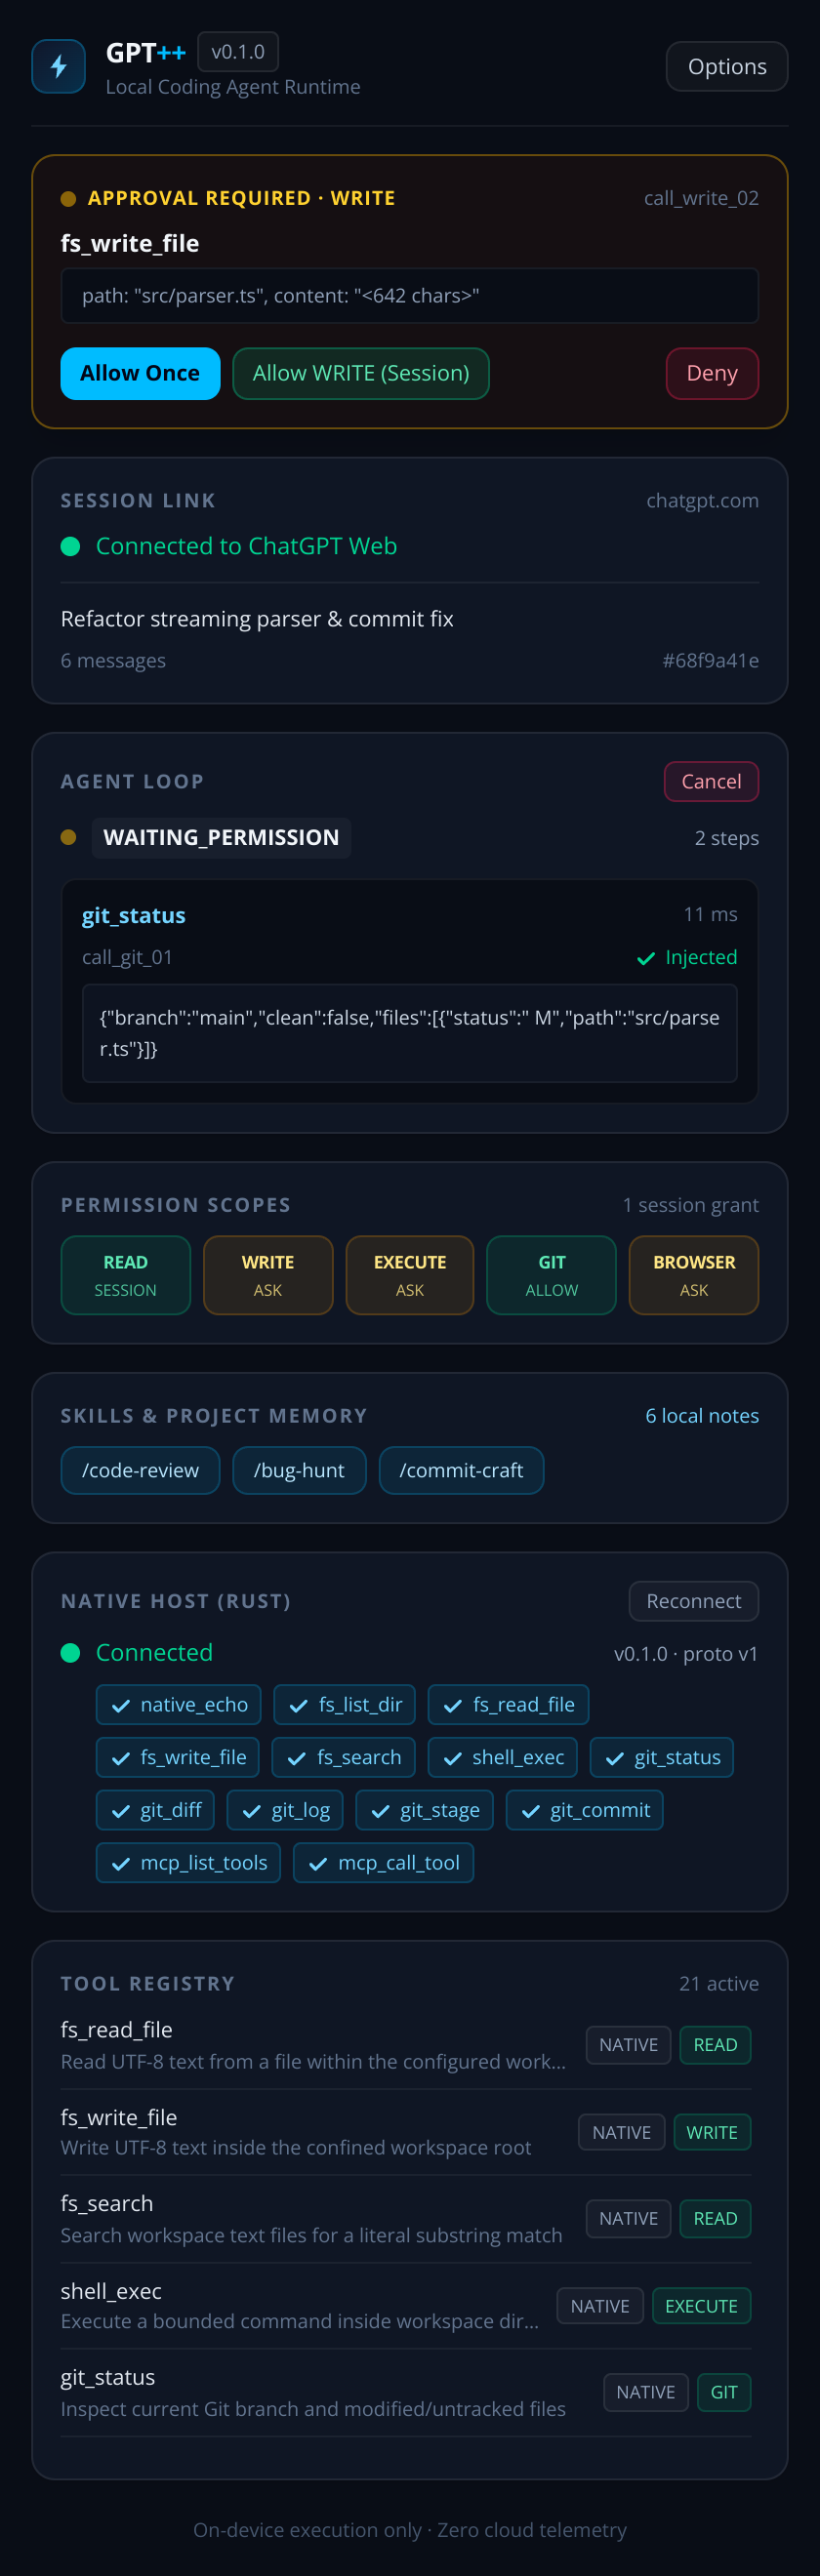
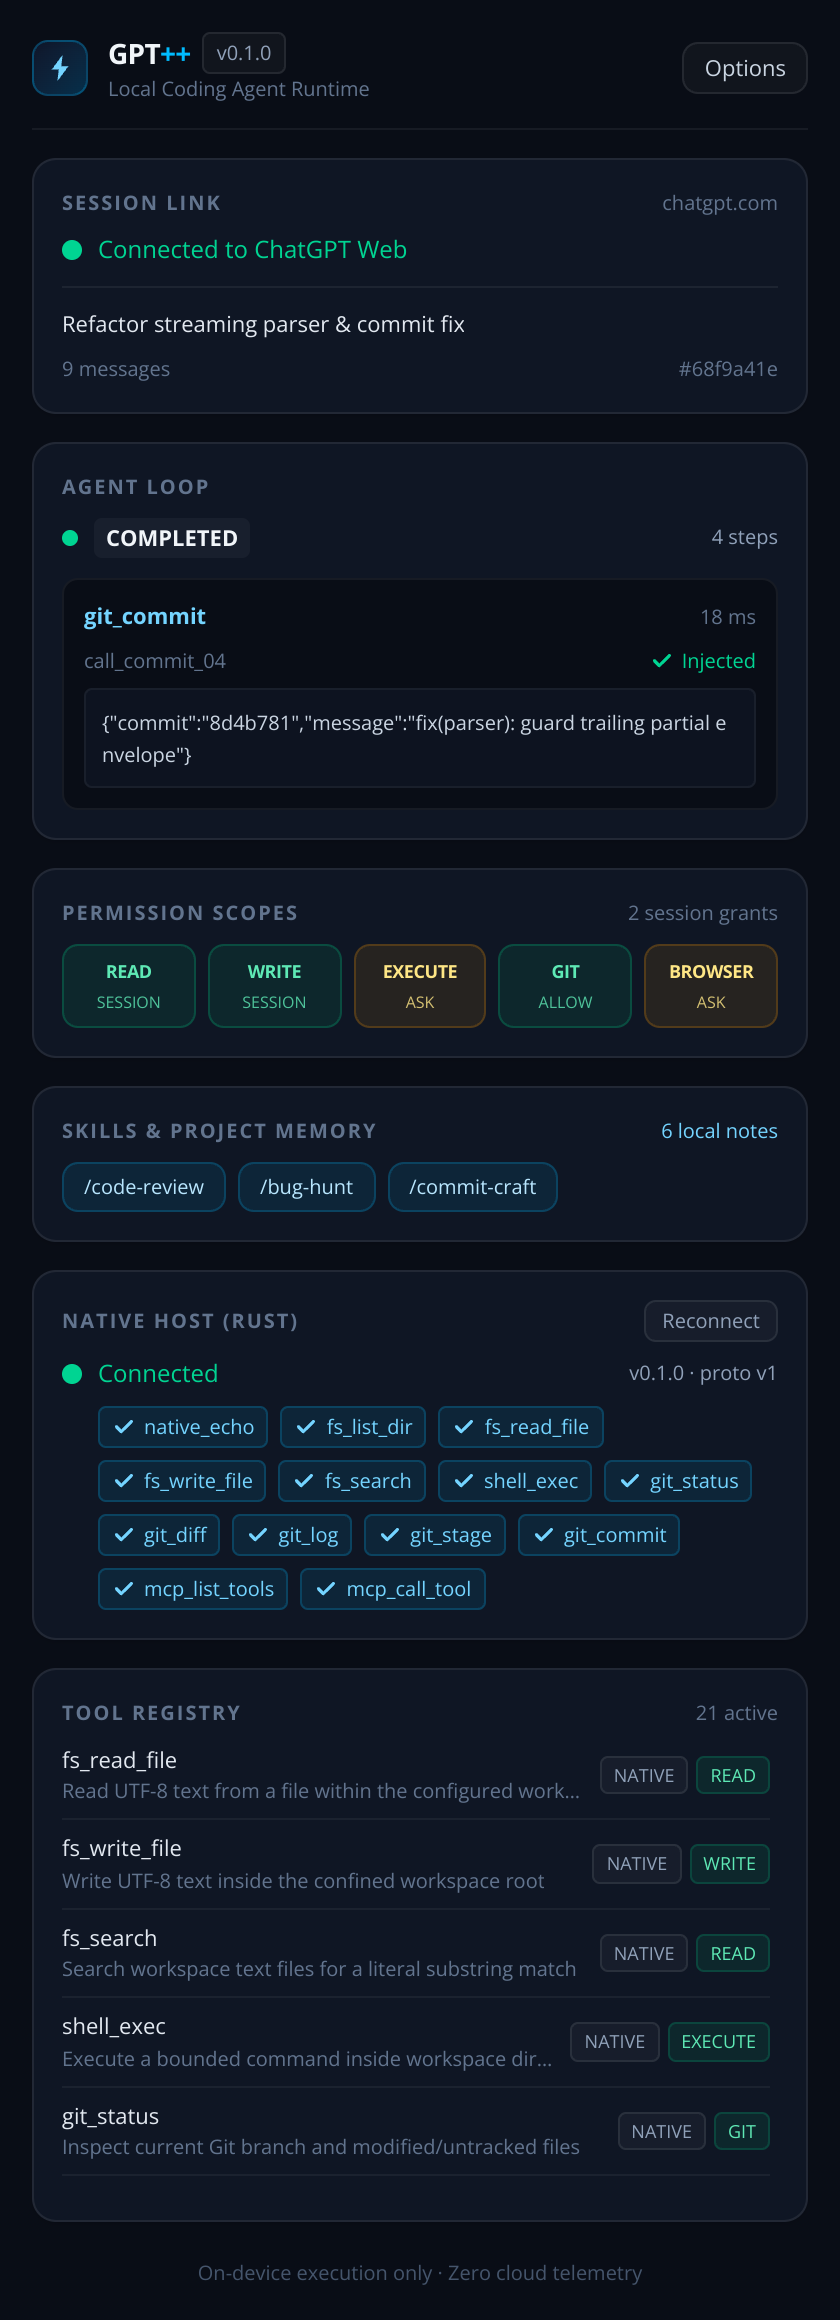
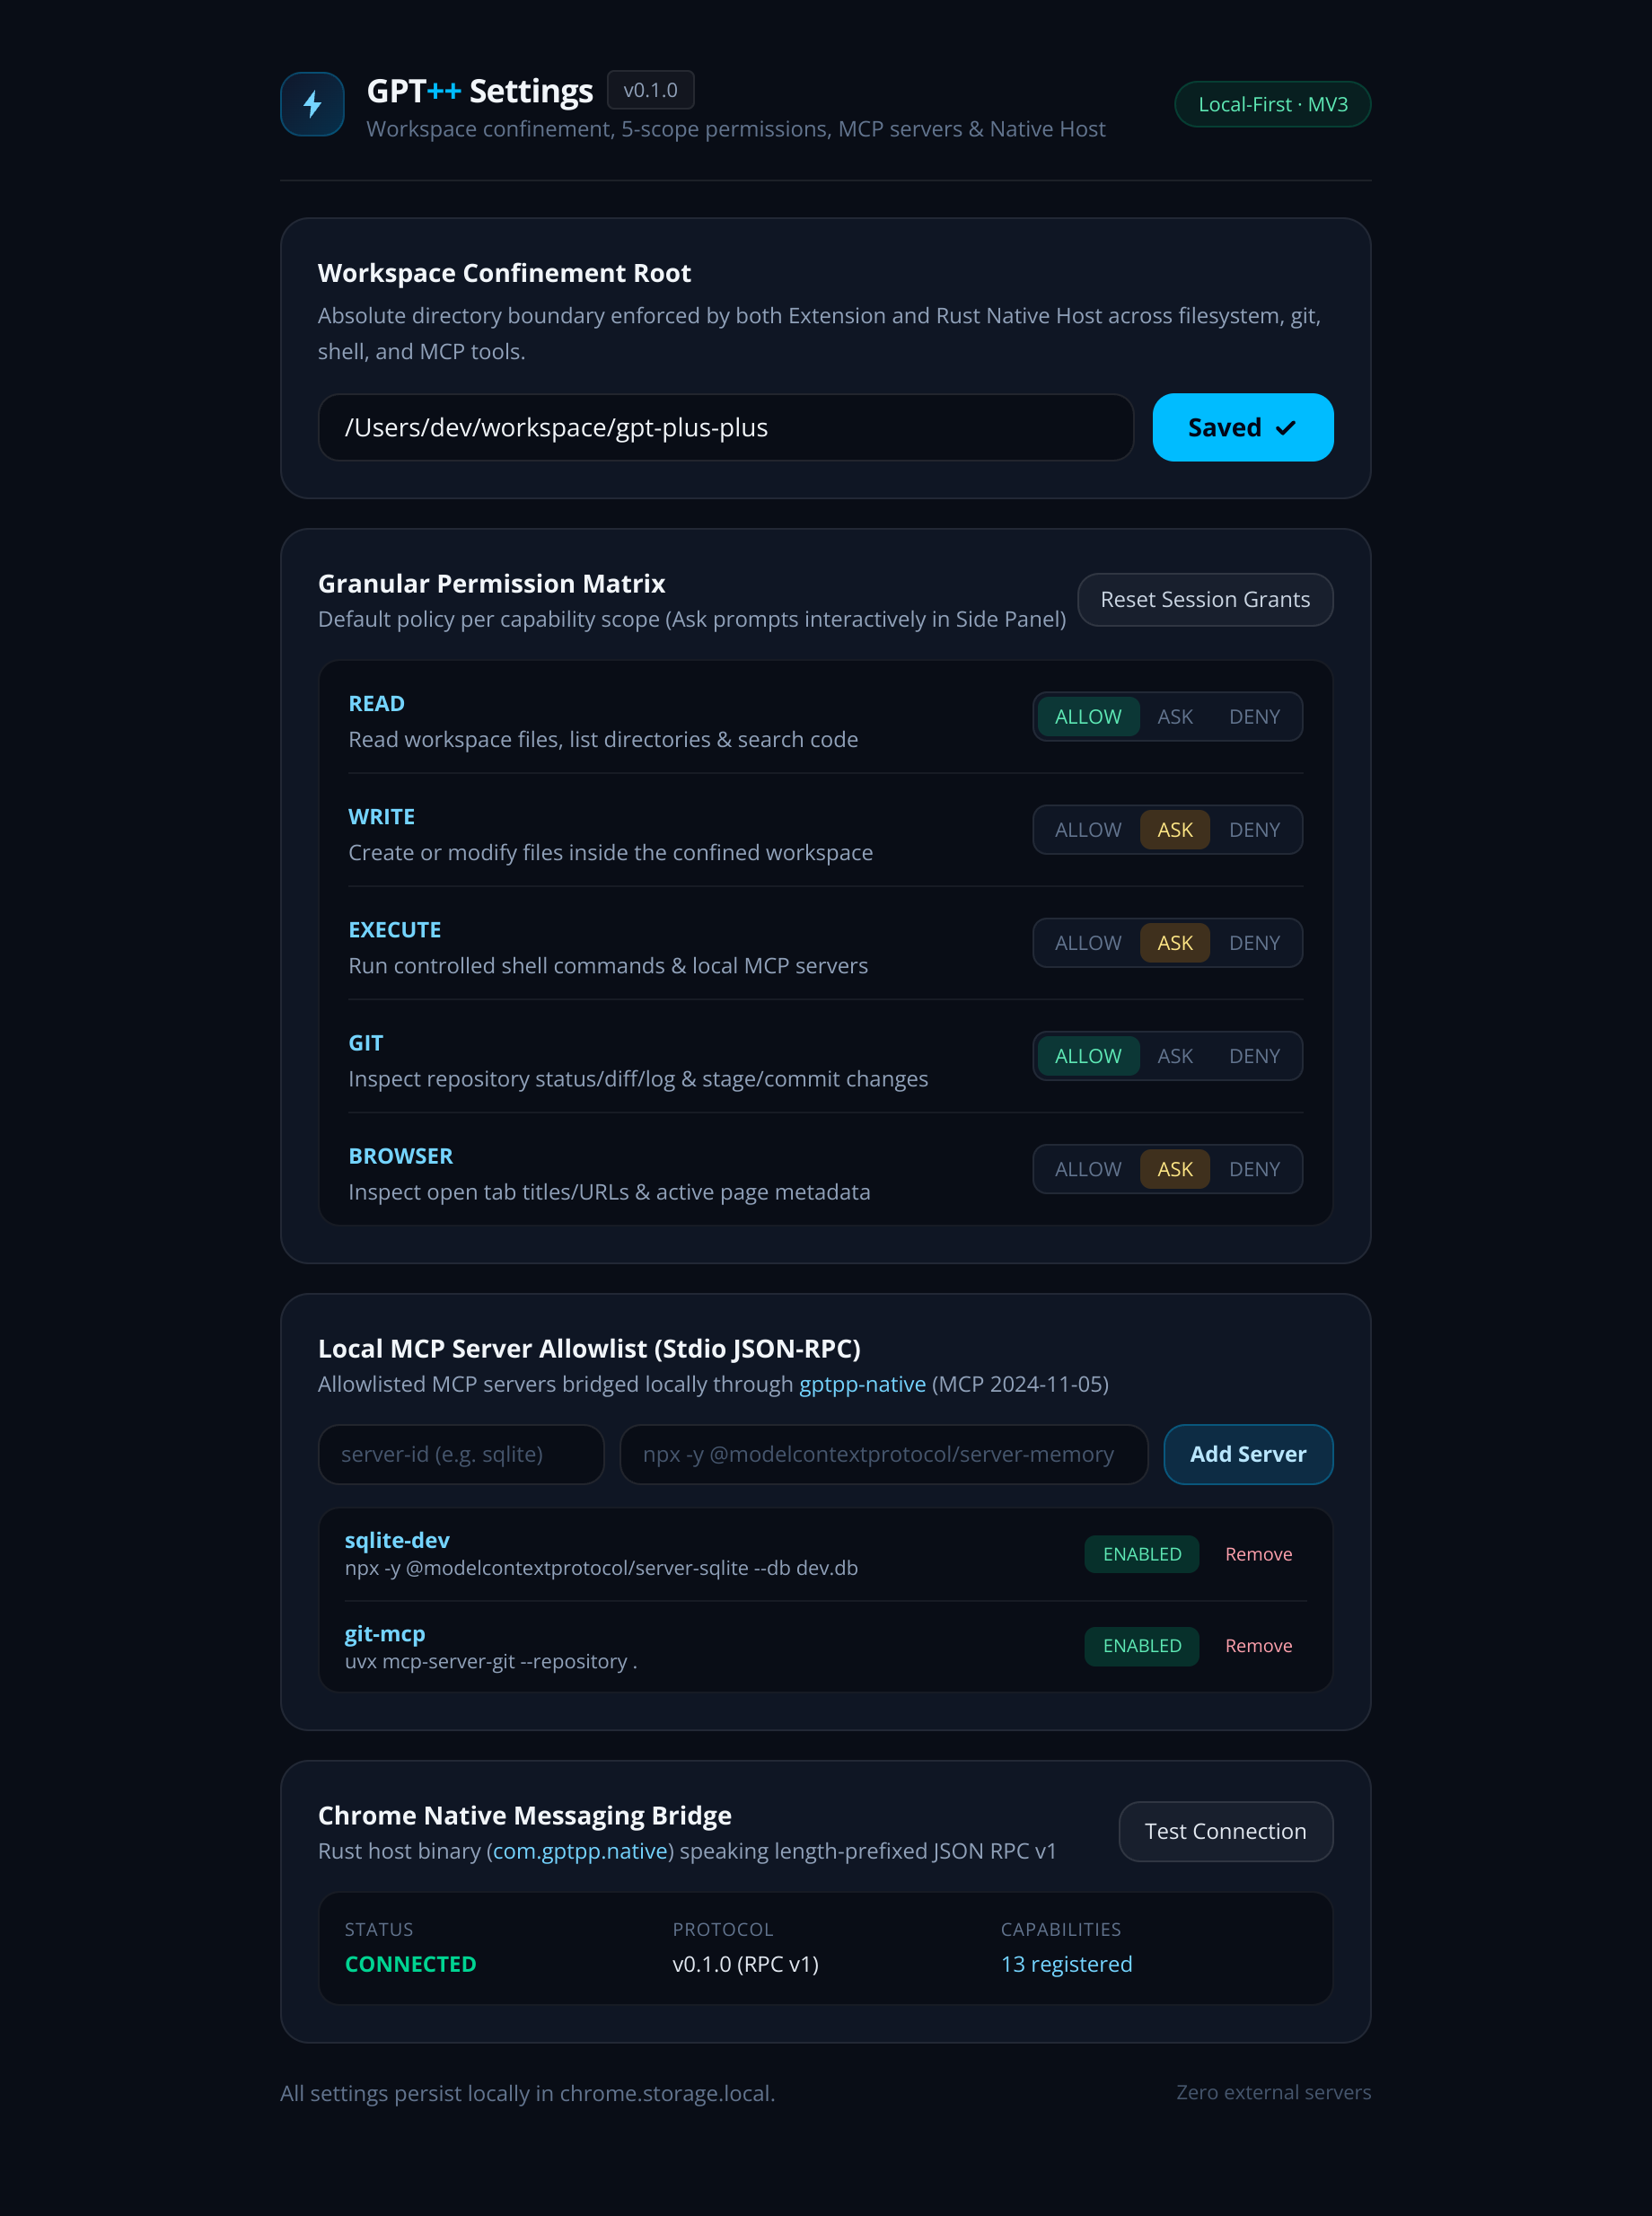
- 浏览器扩展层(WXT + React 19 + TypeScript,约 5,900 行):Closed Shadow DOM 内隔离的状态胶囊、Side Panel 审批卡片、Options 白名单配置
- Rust 原生宿主(
native-host/,约 1,600 行):经 Chrome Native Messaging 提供文件系统、受控 Shell、原生 Git 与 MCP stdio 桥接 - 五域权限引擎:
READ/WRITE/EXECUTE/GIT/BROWSER,支持会话级授权与一键中断 - 测试:121 个 TypeScript + 18 个 Rust 测试,GitHub Actions CI 全绿(我核对过仓库,数字属实)
21 项本地能力矩阵
| 领域 | 工具 | 执行层 / 权限域 |
|---|---|---|
| Filesystem | fs_list_dir fs_read_file fs_write_file fs_search | Rust · READ / WRITE |
| Shell | shell_exec | Rust · EXECUTE |
| Native Git | git_status git_diff git_log git_stage git_commit | Rust · GIT |
| Memory | memory_remember memory_recall memory_forget | MV3 · safe |
| Skills | skill_list skill_activate | MV3 · safe |
| MCP Bridge | mcp_list_servers mcp_list_tools mcp_call_tool | Rust · EXECUTE |
| Browser | browser_list_tabs | MV3 · BROWSER |
| Diagnostics | native_echo demo_echo | Rust / MV3 · safe |
关键设计
1. 双层工作区沙箱:符号链接逃逸防护
网页端的任何 DOM 内容都被视为不可信输入。Extension 侧先归一化相对路径,
Rust 侧再用 std::fs::canonicalize 解析真实路径做二次校验,
彻底阻断 ../ 穿越、前缀同名碰撞与符号链接逃逸。
下面是 native-host/src/sandbox.rs 的核心逻辑:
if raw_path.contains('\0') {
    return Err("path contains illegal null byte".to_string());
}

if joined.exists() {
    let canon = fs::canonicalize(&joined)
        .map_err(|e| format!("cannot canonicalize \"{effective}\": {e}"))?;
    if !canon.starts_with(canon_root) {
        return Err(format!(
            "access denied: \"{effective}\" escapes workspace root"
        ));
    }
    return Ok(canon);
}

// 目标尚不存在:回溯到最深的已存在祖先,canonicalize 后
// 校验剩余新路径段只含 Normal 分量(拒绝 . / .. 逃逸)
for seg in &missing_tail {
    for comp in Path::new(seg).components() {
        if !matches!(comp, Component::Normal(_)) {
            return Err(format!(
                "illegal path segment in target path \"{effective}\""
            ));
        }
    }
}
最难的一处是目标文件尚不存在时(如写入新文件)——此时无法直接 canonicalize。
这里的处理是回溯到最深的已存在祖先做校验,再逐段检查新增路径分量,
确保 .. 不会藏在不存在的路径段里绕过检查。
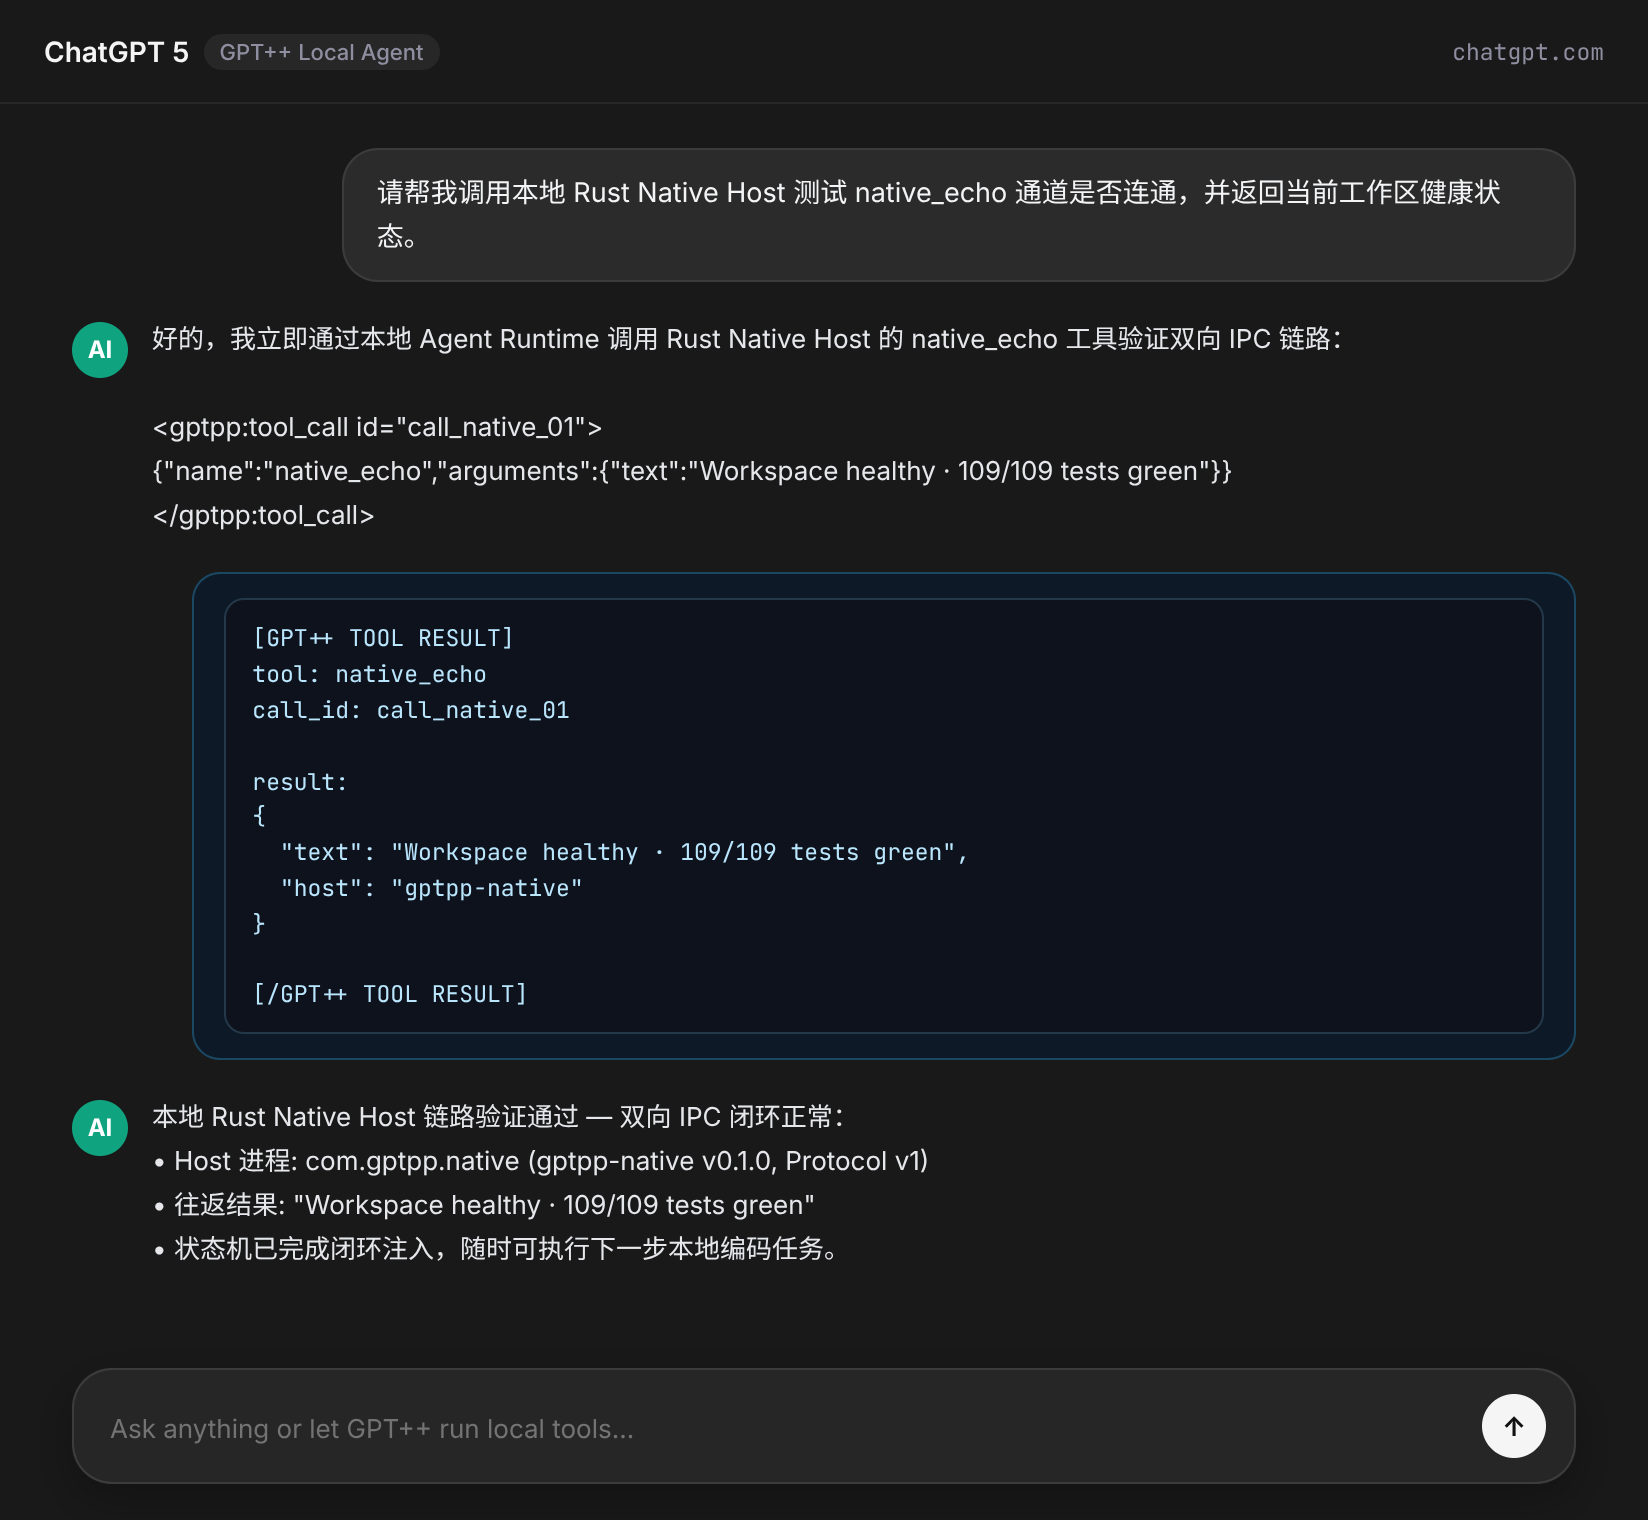
2. 确定性 Agent 状态机
AgentLoopController 由显式状态转移表驱动,任何非法跨态跃迁都会被 AgentStateMachine 立即拒绝。
这一点和我写 AgentOS 时的判断一致:自动化系统的状态必须是可观测、可追问的,
而不是埋在日志里的一句 error。
IDLE ──▶ OBSERVING ──▶ TOOL_DETECTED ──▶ WAITING_PERMISSION ──▶ EXECUTING
             ▲                                                      │
             └─────────── CONTINUING ◀──── INJECTING_RESULT ◀───────┘
3. 零命令夹带的 MCP 白名单
调用 mcp_call_tool 时模型只能传 serverId,
实际可执行文件与参数完全由用户在 Options 页显式配置。
这样即使提示词被注入,也无法触发任意程序执行——这是 MCP 生态里一个很实际的攻击面。
实机运行截图
viral-writer-skill
github.com/laolaola278-dev/viral-writer-skill
和纯提示词 Skill 的关键差别
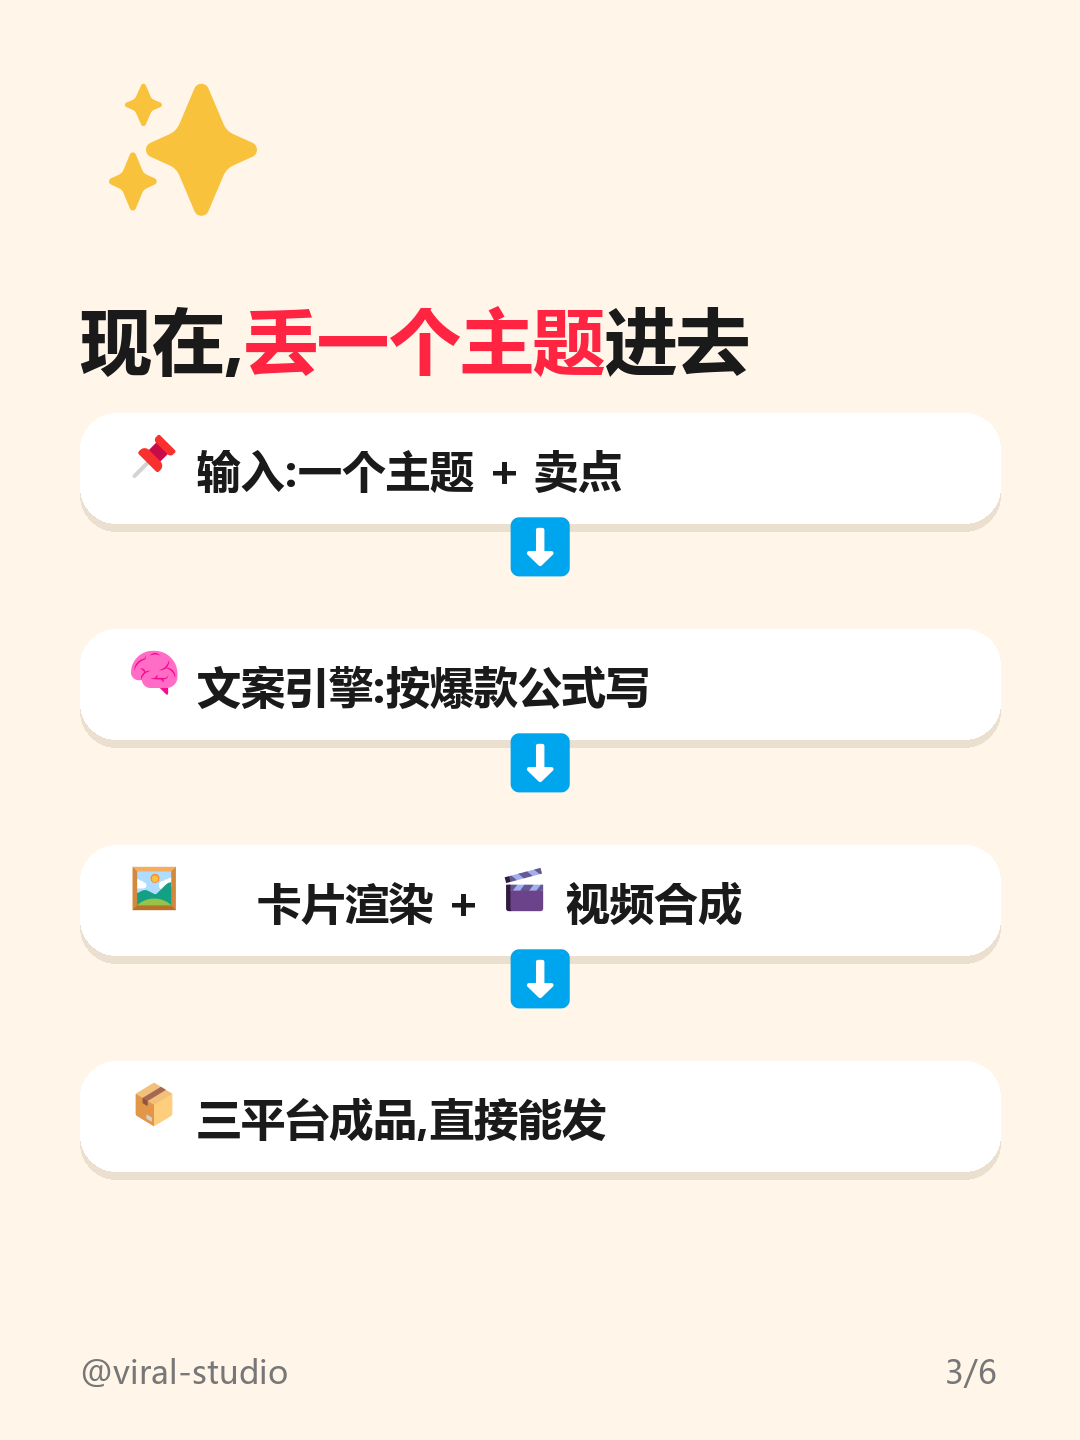
大多数内容生成 Skill 只做一件事:教 AI 怎么写,最后交给模型"再画一遍图"。 这个 Skill 的不同在于——它带可执行工具,产物是成品文件: 卡片由 Pillow 确定性渲染成真实 PNG,视频自动 TTS 配音、按配音时长对齐字幕并加转场。 模型负责文案与结构,确定性代码负责像素与时间轴。
能力
- 小红书:5 个标题候选(标注公式)+ 正文 + 8–10 标签 + 6 张 1080×1440 卡片(PNG)
- 抖音:黄金 3 秒钩子脚本 + 配文 + 竖屏成片(TTS 配音 / 字幕对齐 / 转场)
- 知乎:1500–3000 字结构化长文(含实测表格与诚实声明段落)
- 一鱼多吃:同一主题按平台语感重写,明确禁止一稿多发
- 移动端 H5:纯静态网页,浏览器直连 LLM API + Canvas 本地渲染卡片
渲染链路
# 卡片:JSON 规格 → 1080x1440 PNG(Pillow 渲染,零浏览器依赖)
python render_cards.py cards_dir/ out_dir/

# 视频:TTS 配音 → 按配音时长对齐字幕 → 转场 → 竖屏成片
python make_video.py script.json --bgm your_music.mp3
有一个细节值得说:render_cards.py 会按队列探测各平台的中文字体,
找不到任何 CJK 字体时明确报错退出,而不是渲染出一堆方框继续交付;
找不到 emoji 字体时才降级剥离继续。
我这次想实机跑一遍时正好缺中文字体,脚本如预期报错——这个"该失败就失败"的设计我是认可的。
产物示例
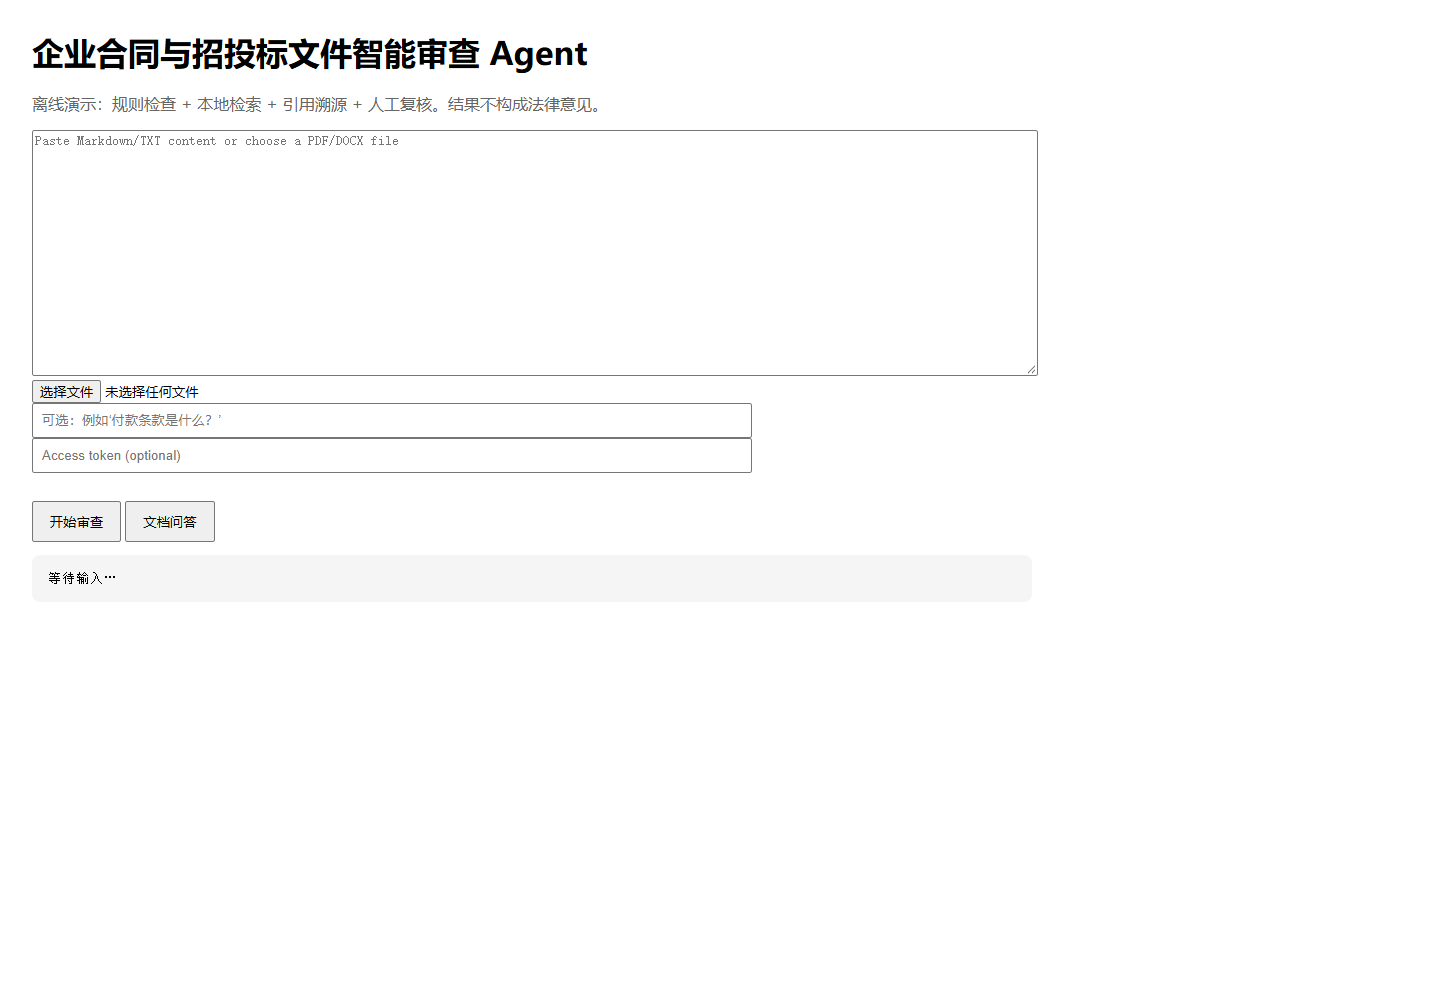
企业合同与招投标文件智能审查 Agent
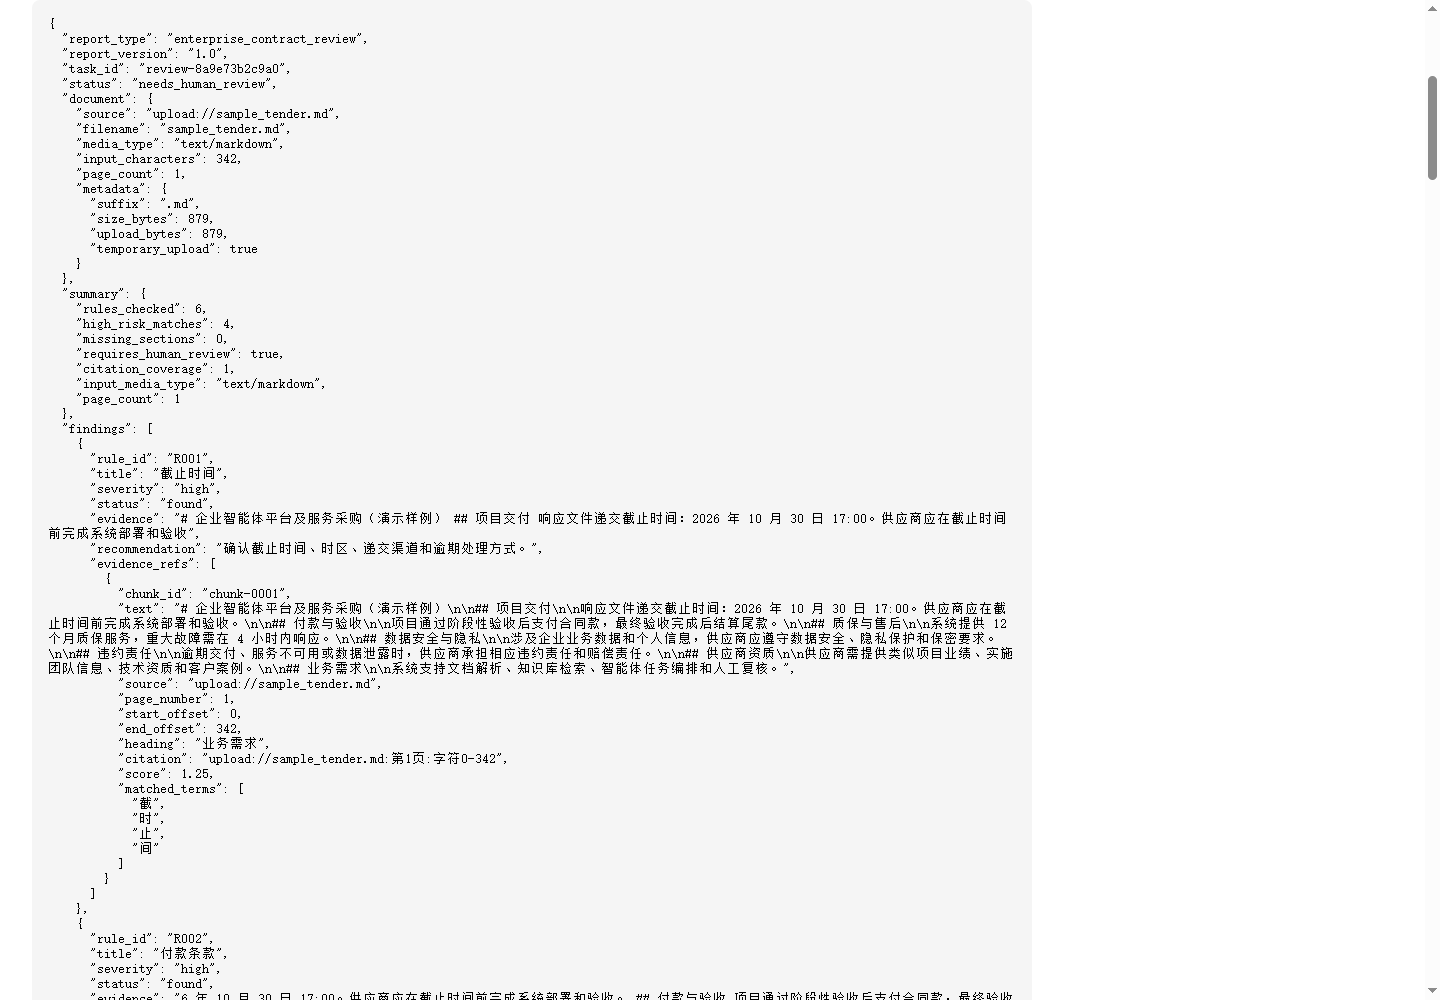
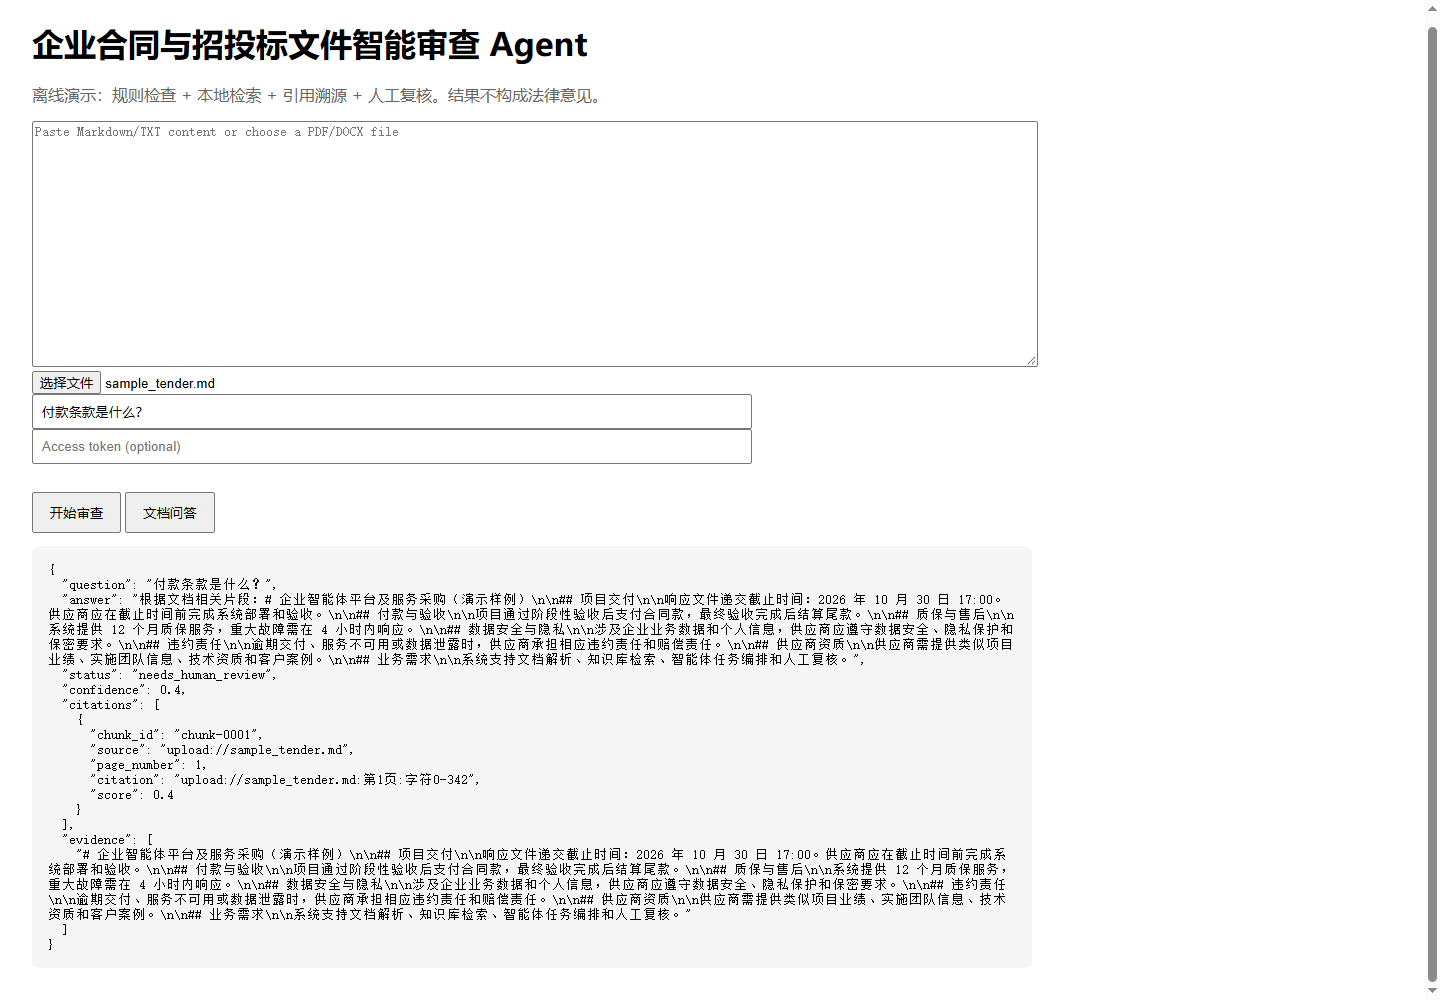
一个面向高风险企业文档的审查 Agent。设计上最值得说的一点,是它刻意不接 LLM: 风险判定全部由可枚举、可回归测试的确定性规则产生,每条结论都回指到原文的文件 + 页码 + 字符偏移, 最后由一道人工复核门闭环。README 里那句话我原样认同—— 「一个说不清依据的结论,比没有结论更糟」。
为什么先做规则引擎
合同审查是低容错场景。LLM 的语义能力确实能覆盖规则想不到的条款, 但用它的输出去掩盖不确定性是危险的。所以这里的取舍是: 先用规则把「可解释、可测试、可回归」的地基打牢,LLM 的位置留给规则覆盖不到的语义条款, 而不是拿它当不确定性的遮羞布。当前版本不调用任何外部模型。
六条可枚举规则
| 规则 | 检查项 | 等级 | 命中后提示人工确认 |
|---|---|---|---|
| R001 | 截止时间 | high | 时间、时区、递交渠道、逾期处理 |
| R002 | 付款条款 | high | 付款节点、发票条件、验收条件、逾期付款责任 |
| R003 | 质保与服务 | medium | 服务范围、响应时间、SLA、质保期限、费用边界 |
| R004 | 数据安全与隐私 | high | 数据分类、访问权限、留存期限、脱敏与泄露处置 |
| R005 | 违约与责任 | high | 责任上限、违约金计算、免责条件、争议解决 |
| R006 | 供应商资质 | medium | 资格、资质、业绩、案例等证明材料 |
关键源码:每条结论都带证据,且强制人工复核
def run_review(text: str) -> dict[str, object]:
    """Run explainable checks and return a stable structured result."""
    if not isinstance(text, str):
        raise TypeError("text must be a string")
    if not text.strip():
        raise ValueError("text must not be empty")
    findings: list[Finding] = []
    for rule in RULES:
        matched = any(re.search(p, text, flags=re.IGNORECASE) for p in rule["patterns"])
        findings.append(
            Finding(
                rule_id=rule["rule_id"],
                title=rule["title"],
                severity=rule["severity"] if matched else "low",
                status="found" if matched else "missing",
                # 命中 -> 回指原文片段;未命中 -> 明说"未找到",请人工确认
                evidence=_evidence(text, rule["patterns"]) if matched
                         else "未找到相关条款,建议人工确认。",
                recommendation=rule["recommendation"],
            )
        )
    return {
        "summary": {
            "rules_checked": len(findings),
            "high_risk_matches": sum(1 for f in findings
                                     if f.severity == "high" and f.status == "found"),
            "missing_sections": sum(1 for f in findings if f.status == "missing"),
            "requires_human_review": True,   # 硬编码:结论必须经人确认
        },
        "findings": [asdict(item) for item in findings],
    }
实测结果
我在本地克隆并跑通了它的测试套件(Python 3.11 虚拟环境):
23 passed, 1 skipped, 12 subtests passed in 1.81spyproject.toml
带了 UTF-8 BOM(前 3 字节 EF BB BF),导致任何 TOML 解析器在第一列就报错,
pytest 直接起不来——这也是该仓库 CI 红的原因之一。
我剥掉 BOM 后测试即全绿。上游仓库目前仍未修复。
运行效果
Cyber Agent Platform (CAP)
github.com/laolaola278-dev/cyber-agent-platform
项目概况
一个企业级安全编排控制平面,通过稳定接口统一管理 Asset(资产)、Knowledge(知识)、Assessment(评估)、Detection(检测)、Incident(事件)、 Response(响应)、Notification(通知)、Worker、Sandbox(沙箱)、Telemetry(遥测)、 Plugin(插件)、Playbook(剧本)等能力,并配套 RBAC、审批、审计与可观测性。
- 后端:FastAPI / SQLAlchemy / PostgreSQL / Redis
- 前端:React / TypeScript / Vite / Ant Design
- 架构约束:PostgreSQL 为唯一可信数据源;Worker 使用 lease/fencing 机制;插件不得直接访问平台持久化层
- 许可证:Apache 2.0
⭐ 工程规范:这个项目最值得看的部分
1. 质量闸门(零警告预算 + 覆盖率门槛)
make install && make check      # 完整闸门

uv run --project backend ruff check backend/app backend/tests benchmarks/phase22
uv run --project backend pytest backend/tests -p no:cacheprovider
npm ci --prefix frontend
npm run lint --prefix frontend -- --max-warnings=0
npm test --prefix frontend
npm run build --prefix frontend- Ruff + ESLint 采用零警告预算(
--max-warnings=0)——不是"尽量没有警告",而是有一条警告就失败 - CI 强制后端覆盖率 90%(infra-less job)。文档还说明了 95% 目标的前提:需计入容器与 PostgreSQL 认证测试的贡献,而这部分只在认证工作流中产生
- 此外还有 Compose / Helm 校验、Docker 构建、npm 生产依赖审计、Trivy 基线扫描
2. 发布与版本治理
- 遵循 Semantic Versioning 2.0.0,且
1.0.0-rc1优先级低于正式1.0.0 - 已发布内容不可变:发布后如需更正,必须发新的 RC,而非就地修改
- 1.0.0 之后:兼容的 bug 修复递增 PATCH,兼容的新增递增 MINOR,破坏性变更递增 MAJOR
- 当前 1.0.5,公开 API 自 1.0.0 起冻结;1.0.1–1.0.5 仅含缺陷修复、安全与来源治理、认证工作和控制台重构
- 每条发布线都在各自的 RC 锚点做过 fail-closed 认证
3. 运维文档链完整
这是我见过的同类项目里文档最齐的之一,覆盖生产上线后的全生命周期:
docs/deployment/production-checklist.md   生产检查清单
docs/deployment/upgrade.md                升级
docs/deployment/rollback.md               回滚
docs/deployment/backup-restore.md         备份与恢复
docs/operations-guide.md                  运维指南
docs/runbook.md                           Runbook
docs/faq.md                               FAQ
docs/architecture.md / api-guide.md       架构与 API
docs/plugin-development-guide.md          插件开发
docs/sdk-guide.md                         SDK
docs/adr/                                 架构决策记录
docs/releases/ · CHANGELOG.md             发布记录与变更日志
docs/known-issues.md · docs/roadmap.md    已知问题与路线图
安全边界设计
X-CAP-User 与 X-CAP-Proxy-Secret。
项目原文态度很明确:"浏览器状态和隐藏按钮不是安全边界,后端 RBAC 才是权威。"
生产启动会拒绝仓库内的占位密钥与 debug 模式。
诚实声明(项目原文立场)
把"我做到哪一步、没做到哪一步"写进 README 而不是留给使用者自己发现, 是这个项目一贯的风格,也和我其他项目的做法一致。
RailMind
github.com/laolaola278-dev/RailMind
数据规模
| 指标 | 值 |
|---|---|
| ticket_snapshot 记录数 | 3,213,412 |
| 覆盖路线数 | 400 |
| 覆盖车次数 | 3,795 |
| 座位类型数 | 10 |
| 数据时间范围 | 3 天(07-26 ~ 07-29) |
| 特征数(无泄漏) | 8 |
技术链路
12306 API
  │  (curl_cffi TLS 指纹模拟 + APScheduler 定时采集 + PeakMode 调频)
  ▼
PostgreSQL ticket_snapshot(3.2M+ 记录,月度 RANGE 分区)
  │  (EventPublisher)
  ▼
Kafka(railmind.ticket.raw · acks=all · idempotence · lz4)
  │
  ▼
Flink Consumer(PyFlink 流计算)
  │  特征计算: query_count_1h, demand_score, availability_rate ...
  ▼
PostgreSQL ticket_features_realtime(实时特征表)
  │
  ▼
DatasetBuilder(extract_baseline_features → 无泄漏三分类目标)
  │  0=no_ticket / 1=sold_out / 2=available
  ▼
Model Zoo(LR / RF / XGBoost / LightGBM)→ Model Registry → Serving Engine
  │
  ▼
Prediction API(FastAPI)→ Frontend(Vue 3.5 + ECharts)
⭐ 核心技术突破:数据泄漏的定位与修复
这是整个项目最有价值的部分,完整记录了「发现异常 → 定位根因 → 修复 → 重新评估」的工程闭环。
第一步:识别虚假的完美
首个 Baseline(线性回归预测 remaining_count)在测试集上得到 R² = 1.0(RMSE ≈ 10⁻¹³,已达机器精度)。
这是数据泄漏的明确信号,而非真实预测能力——能识别这一点本身就是关键能力,很多初学者会把它当成好结果上报。
第二步:定位 3 个泄漏特征
| 泄漏特征 | 泄漏原因 |
|---|---|
previous_remaining | 首条记录以当前 remaining_count 回填 |
remaining_change | 定义为 remaining_count - previous_remaining,可反推出目标 |
rolling_mean | 滚动窗口包含当前 remaining_count 值 |
模型实际学到的只是一个恒等式 remaining_count ≈ previous_remaining + remaining_change,其余特征系数趋近于 0。
第三步:修复
- 目标由回归(
remaining_count)改为三分类(seat_status:no_ticket / sold_out / available) - 移除 3 个泄漏特征
- 以 Logistic Regression 作为可信基准重新训练
第四步:重新评估与模型对比
| 模型 | Accuracy | F1 Macro | ROC-AUC | 训练耗时 |
|---|---|---|---|---|
| Logistic Regression(基准) | 0.5425 | 0.4841 | 0.6912 | 70.98s |
| Random Forest | 0.7371 | 0.7231 | 0.8979 | 2.29s |
| XGBoost | 0.7474 | 0.7381 | 0.8985 | 0.68s |
| LightGBM(最优) | 0.7556 | 0.7461 | 0.9065 | 0.50s |
完整轨迹:虚假 R²=1.0 → 真实 ROC-AUC 0.6912(LR 基准)→ 0.9065(LightGBM 最优)。 4 个模型在同一数据集(100K 采样)、同一特征(8 个无泄漏特征)、同一切分(80/20, random_state=42)下对比。
其他工程要点
- 模型热替换:Serving Engine 支持运行时换模型,相同
model_id热替换,API 全程无感知,无需修改任何调用方代码 - 工程规范:30 条 ADR(架构决策记录)、1570+ 后端测试、Docker Compose 14 服务(非 root + read_only 文件系统)
- 安全加固:JWT + RBAC、速率限制、安全响应头、审计日志、日志脱敏
性能指标
| 场景 | QPS | P50 | P99 | 错误率 |
|---|---|---|---|---|
| 顺序(n=5000) | 184 | 4.58ms | 11.39ms | 0.00% |
| 并发(n=5000, 10 workers) | 65 | 116.10ms | 352.34ms | 0.00% |
| 稳定性(5 分钟) | 193 | 4.38ms | 8.47ms | 0.00% |
推理性能:模型加载 1.60s · 首次(冷启动)6.66ms · 平均(热)0.65ms · P99 1.75ms · 批量 100 样本 62.55ms。 资源占用:CPU 平均 198%(约 2 核)、内存 291MB。
ScreenForge
github.com/laolaola278-dev/ScreenForge
它是什么
一个 Windows 原生视频录制程序,核心思路是全程让数据留在 GPU 上:
从屏幕捕获到编码不经 CPU 回读,避免每帧在显存与内存之间来回搬运。
规模约 7,300 行 C++(28 个 .cpp + 35 个 .h + 16 个 CMakeLists.txt),
依赖 Qt6 / Direct3D11 / WGC / NVENC / WASAPI / FFmpeg。
WGC 屏幕捕获 ──┐
               ├─→ FrameQueue(SPSC 无锁队列) ─→ NVENC 编码 ─→ MP4 封装
WASAPI 音频 ───┘
(QPC 统一时钟)    (60fps Pacing,满丢最旧)    (GPU 零拷贝)    (fragmented MP4)
几个值得说的点:采集与编码之间用 SPSC 无锁队列解耦(单生产者单消费者,避免锁竞争抖动); 音视频用 QPC 统一时钟对齐,避免长时间录制后音画漂移; 队列满时丢弃最旧帧而不是阻塞采集线程,保证实时性优先。
为什么放进作品集
坦白说,它和我主线的「大模型 Agent 工程」不在一条线上。我放进来有两个理由: 一是它证明我能处理系统级复杂度——GPU 管线、无锁并发、音视频同步、硬件编码器, 这些都不是靠调 API 能糊过去的; 二是它的工程过程管理比很多 AI 项目更扎实,下面这点尤其重要。
必须说清楚:它没有在真机上跑过
项目的验收报告里,5 项硬件测试全部标记为 NOT_TESTED,并附了这样一段声明:
「当前生成环境为浏览器沙盒,无法执行 Windows API / MSVC / FFmpeg / NVENC / GUI。 本报告不填写任何模拟数据,全部项目标记 NOT_TESTED,待真机执行后回填。」
也就是说:这个项目的正确性只经过静态审计,没有被编译运行验证过。 我可以用环境受限来解释,但没法用任何方式宣称它"能跑"。 所以我给它标的是「静态审计通过 · 未实机验证」,而不是「代码审计通过」。
我仍然把它放进来,是因为面对无法验证的事情选择如实标注,
本身就是一个值得展示的工程习惯——一个敢把 5 项测试全写成 NOT_TESTED 的人,
写「已验证」的时候大概是可信的。
工程过程管理
- 渐进式阶段开发:Phase 0–8 逐阶段交付,每阶段产出可编译的真实代码,GitHub Actions 自动构建
- 代码真实性审计(
CODE_REALITY_AUDIT.md):静态扫描 + 调用链逐级核对,区分「编译链实际引用」与「历史冻结(保留未编译)」,明确标出哪些文件已移出构建 - 占位实现审计(
CODE_STUB_REPORT.md):结论为无 TODO/FIXME/占位实现,且接口-实现-调用方三者一致;同时注明「本环境无法执行 MSVC,以下为静态审计结论」 - 代码冻结:
CODE_FREEZE.md固化 Release Candidate 状态,历史工程保留但不参与构建
仓库里共有 12 份工程报告(构建、依赖、清理、冻结、审计、验收、发布候选各一份体系)。 这种"把过程本身也当作交付物"的做法,是我从 cyber-agent-platform 的零告警预算那里学来的。
Atlas — 医疗智能体临床协作平台
这是我体量最大的项目:两万行 Go,面向医疗机构的临床协作、文书、审核与可审计层。 吸引我写它的原因不是规模,而是它逼着我把「AI 不能做什么」写进架构里—— README 开篇就把边界钉死了:不做自主诊断决策、不做自动处方、不替代执业医师; 所有 AI 输出均为建议,必须经人工签核;原始诊疗数据「数据不出院」, 院外仅允许经批准的脱敏聚合指标。
开发原则的排序
这个项目最让我认同的,是它把价值排序显式写出来了:
患者安全 > 合规 > 正确性 > 可观测性 > 性能 > 代码量审计哈希链:让「悄悄改一条记录」不可行
涉及医疗文书,光有日志不够——日志本身可以被改。所以平台实现了
审计哈希链(services/atlas-audit/chain.go):
每条审计记录携带前一条的哈希,任何中间记录的改动都会导致后续校验全部失效,
从而让「悄悄改一条记录」在计算上不可行。
门禁:把「合规」做成会失败的检查
项目没有把规范写进文档就算完,而是做成了 CI 门禁(.github/workflows/ci.yaml),每次 push / PR 强制执行:
| 门禁 | 检查内容 |
|---|---|
| Planning gate | 首轮交付规划完整性校验 |
| PHI gate | 扫描全仓库,阻断任何疑似患者隐私信息入库 |
| P0–P8 traceability | 需求 → 实现 → 证据的可追溯矩阵 |
| Evidence index drift | 证据清单与实际产物是否漂移 |
| Contract YAML parse | OpenAPI / AsyncAPI 契约可解析 |
| Official FHIR validator | 按固定 SHA-256 下载官方校验器,跑 R4 验收 |
实测结果:828 项测试
我在本地克隆并完整执行了门禁测试套件:
Ran 828 tests in 12.966s
FAILED (failures=1, errors=2, skipped=4)python-gates job
在「Scanner unit tests」这一步失败,导致后续 FHIR 验收、可追溯矩阵等步骤全部 skipped。
但同一次运行里的 official-fhir-validator job 全绿(含官方引擎单元测试与 R4 验收)。
所以现状是:核心医疗功能通过,卡在 PHI 白名单配置这一步。